2026 Grok Imagine Video 1.5 en Kinovi: cinco opciones, de cortos creativos a anuncios de producto
Cinco ejemplos reales de video con prompts originales e imágenes de referencia, más especificaciones, precios y preguntas frecuentes de Grok Imagine Video 1.5 y Lite en Kinovi.
En resumen: Una florería sobre las nubes, una fotografía que se convierte en una playa en movimiento y un comercial de reloj armado a partir de tres referencias visuales: la familia Grok Imagine Video 1.5 está disponible en Kinovi a través de cinco opciones estándar y Lite. Esta guía reúne cinco videos existentes, sus imágenes de entrada, prompts completos, especificaciones y precios actuales para ayudarte a elegir un punto de partida para tu propio proyecto.
Un proyecto de video con IA suele comenzar con el material que ya tienes. Una idea escrita necesita un mundo a su alrededor. Una fotografía necesita movimiento. Imágenes separadas de producto, exhibición y ubicación necesitan convertirse en un solo plano.
Los ejemplos siguientes siguen este orden: text-to-video estándar, image-to-video estándar, reference-to-video estándar, text-to-video Lite e image-to-video Lite. Cada uno ilustra una tarea creativa distinta. Sus escenas, duraciones y entradas difieren, por lo que esto es un escaparate más que una comparación controlada entre estándar y Lite.
1. ¿Qué aporta Grok Imagine Video 1.5 al flujo de trabajo?
El anuncio de lanzamiento de xAI destaca mejoras en movimiento, física y audio, incluyendo movimiento más coherente y efectos de sonido, ambiente y diálogo que se ajustan mejor a la acción. Estas son descripciones del proveedor; los ejemplos siguientes muestran lo que ocurrió en tareas creativas concretas. Anuncio oficial.
En Kinovi, las cinco opciones abarcan tres modos de entrada y dos versiones:
- Text-to-video: Construye una escena a partir de una descripción escrita, ya sea un plano conceptual, la apertura de una historia o una idea promocional.
- Image-to-video: Parte de una imagen existente. La opción estándar también acepta un fotograma final; Lite usa una sola imagen de inicio.
- Reference-to-video: Usa varias imágenes para especificar un personaje, producto o entorno al componer un plano nuevo. Este modo se ofrece actualmente mediante la opción estándar en Kinovi.
Elegir entre estándar y Lite implica tanto precio como funciones. Lite tiene tarifas listadas más bajas. Requisitos como múltiples referencias visuales o un fotograma final deben orientar la elección del modo de entrada antes que el nombre de la versión.
2. Especificaciones y precios actuales
La siguiente información se verificó frente a las páginas de modelos de Kinovi el 21 de octubre de 2026. Cada opción enlaza a su página de detalle.
| Opción | Entrada | Duración | Resoluciones de salida | Distinción clave |
|---|---|---|---|---|
| Standard text-to-video | Texto | 1–15 segundos | 480p / 720p / 1080p | Construir escenas desde texto |
| Standard image-to-video | Imagen de inicio; imagen final opcional | 1–15 segundos | 480p / 720p / 1080p | Hasta 720p con una imagen final |
| Standard reference-to-video | 1–7 imágenes de referencia y texto | 1–15 segundos | 480p / 720p | Combinar referencias visuales |
| Lite text-to-video | Texto | 1–15 segundos | 480p / 720p / 1080p | Tarifas listadas más bajas |
| Lite image-to-video | Una imagen de inicio; texto opcional | 1–15 segundos | 480p / 720p / 1080p | Animar una sola imagen |
Las cinco opciones admiten una pista de audio y publican un límite de prompt de 4,000 caracteres. Text-to-video y reference-to-video admiten varias relaciones de aspecto. La animación de una sola imagen sigue la imagen de entrada y el comportamiento de encuadre de la opción; el parámetro de relación de aspecto de image-to-video estándar se usa solo cuando se proporciona una imagen final.
La misma etiqueta de resolución de salida no implica el mismo proceso de renderizado. La documentación actual de xAI describe text-to-video e image-to-video estándar como compatibles con 1080p nativo, mientras que Lite alcanza 1080p mediante upscaling desde 720p. Documentación oficial de video.
Tarifas por segundo de video generado
Todos los montos siguientes son USD por segundo de video de salida, no por segundo de espera del resultado.
| Opción | 480p | 720p | 1080p |
|---|---|---|---|
| Standard text-to-video | $0.0501 | $0.0878 | $0.1567 |
| Standard image-to-video | $0.0501 | $0.0878 | $0.1567 |
| Standard reference-to-video | $0.0501 | $0.0878 | Not supported |
| Lite text-to-video | $0.0125 | $0.0188 | $0.0878 |
| Lite image-to-video | $0.0125 | $0.0188 | $0.0878 |
Por ejemplo, a las tarifas actuales de 720p, un clip estándar de ocho segundos es 8 × $0.0878 = $0.7024; un clip Lite de ocho segundos es 8 × $0.0188 = $0.1504. Estas son cálculos ilustrativos, no las facturas reales de los clips siguientes. La relación de precios cambia según la resolución, por lo que no debe aplicarse una sola razón de ahorro a todos los niveles.
Las páginas de text-to-video e image-to-video estándar etiquetan sus tarifas como Preview test pricing. Revisa el monto mostrado al enviar y los términos aplicables de fallo/reembolso para la opción elegida.
Grok Imagine Video 1.5: precios en distintas plataformas
Esta comparación cubre solo Grok Imagine Video 1.5 estándar, excluyendo Lite y modelos anteriores. Verificada el 21 de octubre de 2026. Las columnas de resolución muestran USD por segundo de video de salida, usando tarifas públicas basadas en uso sin conversiones de membresía, créditos de bonificación ni descuentos de suscripción. Las fuentes de precios se listan debajo de la tabla.
| Plataforma | 480p | 720p | 1080p | Cargo adicional por imagen de entrada | Alcance del precio |
|---|---|---|---|---|---|
| Kinovi | $0.0501 | $0.0878 | $0.1567 (text/image) | No desglosado en la página; verificar al enviar | Text e image; reference-to-video hasta 720p |
| Kie | ≈ $0.012 | ≈ $0.0225 | Public rate unverified | No desglosado en la página; verificar al enviar | Tarifas 1.5 Preview publicadas en la página de image-to-video |
| Higgsfield | $0.08 | $0.14 | $0.25 | Cargo separado no verificado | Tarifas de la familia de modelos API 1.5; ver cualificaciones de modo abajo |
| fal | $0.08 | $0.14 | $0.25 (text/image) | $0.01 per input image | Text e image; reference-to-video hasta 720p |
| Segmind | $0.108 | $0.189 | $0.3375 (text/image) | $0.0135 per input image | Text e image; reference-to-video hasta 720p |
| WaveSpeed | $0.08 | $0.14 | $0.25 (text/image) | Single-image mode: $0.01/request; reference mode: $0.01/image | Text e image; reference-to-video hasta 720p |
| xAI official | $0.08 | $0.14 | $0.25 (text/image) | $0.01 per input image | Text e image; reference-to-video hasta 720p |
Fuentes de precios: Kinovi · RunningHub · Kie · Higgsfield · fal · Segmind · WaveSpeed · xAI official
Condiciones que afectan la comparación:
- Kinovi: Text-to-video e image-to-video estándar usan el Preview test pricing listado. Las tarifas del modo de referencia también están disponibles en la página de reference-to-video de Kinovi. Un cargo por imagen que no está desglosado no debe asumirse como cero.
- RunningHub: El catálogo lista $0.08/s para las rutas oficiales estables
xai/grok-imagine-video-v1.5/.../stable, sin tarifas específicas por resolución. Ese monto no puede aplicarse a todos los niveles. Rutas económicas separadasxai/grok-imagine-v1.5/...muestran $0.03/s; su precio por resolución y las capacidades correspondientes permanecen sin verificar, por lo que se anotan por separado en lugar de ingresarse como precios por nivel. - Kie: La página identifica
grok-imagine-video-1-5-previewy lista 2.4 y 4.5 credits/s para 480p y 720p. La tabla usa los equivalentes aproximados en dólares de la página sin créditos de bonificación. Aunque 1080p aparece como opción, su precio no se verificó; no se sustituyen tarifas de otros modelos. Revisa por separado la designación Preview y las condiciones de servicio de cada plataforma. - Higgsfield: Estas son tarifas públicas de la familia de modelos API, no conversiones de suscripción para creadores. La página ilustra el precio con clips de un segundo a 480p/720p y clips de 15 segundos a 1080p. Esto no establece condiciones idénticas para cada duración, modo de referencia o entrada adicional.
- Modos y cargos extra: Los límites de resolución del modo de referencia y los cargos por imagen están documentados en las páginas de fal reference-to-video, Segmind reference-to-video y WaveSpeed reference-to-video. La página de precios de text-to-video de Segmind tiene montos conflictivos en su tabla y prosa explicativa; esta comparación usa la tabla de precios explícita. Confirma el cargo antes de enviar.
Para estimar un total, suma los cargos de entrada divulgados al cargo de generación de video. Por ejemplo, el precio oficial de xAI para un clip de ocho segundos a 720p con una imagen de entrada es 8 × $0.14 + $0.01 = $1.13. La generación solo con texto no tiene cargo por imagen de entrada. “Unverified” no significa “unsupported” ni “free”. Estas cifras son referencias de presupuesto; el precio y las condiciones de servicio mostrados al enviar tienen prioridad.
3. Cinco ejemplos, en orden de modelo
Cada ejemplo incluye el video suministrado, las imágenes de entrada cuando aplica y el prompt original en inglés. El diálogo y las instrucciones de sincronización dentro de un prompt describen la salida prevista; no son una transcripción literal del audio generado. Los comentarios visuales se basan en fotogramas muestreados, y los detalles del archivo provienen de los metadatos del medio. No se realizó una medición palabra por palabra del habla ni de sincronización labial.
| Orden | Opción | Ejemplo | Duración aproximada del archivo | Dimensiones del archivo |
|---|---|---|---|---|
| 1 | Standard text-to-video | Florería sobre las nubes | 15 seconds | 848 × 480 |
| 2 | Standard image-to-video | Entrar en una fotografía de playa | 6 seconds | 848 × 480 |
| 3 | Standard reference-to-video | Comercial de reloj | 8 seconds | 752 × 416 |
| 4 | Lite text-to-video | Lavandería de la luna | 8 seconds | 848 × 480 |
| 5 | Lite image-to-video | Retrato de moda | 15 seconds | 736 × 400 |
Estas son las dimensiones de los archivos recibidos, no las capacidades máximas de los modelos ni una prueba de todos los ajustes originales de envío. Los cinco archivos son de 24 fps y contienen una pista de audio.
1. Standard text-to-video: una florería sobre las nubes
No hay imagen de inicio ni recurso de referencia. El concepto comienza como texto: una terraza de un edificio alto en la hora azul, una florería sobre las nubes, luces prácticas cálidas y una florista arreglando una flor. El prompt también especifica una línea ante cámara, una flor luminosa y un movimiento final de cámara que revela el entorno más amplio.
Modo: Standard text-to-video
Entrada: Solo texto; sin imágenes de referencia.
Archivo: aproximadamente 15 segundos · 848 × 480 · 24 fps · pista de audio presente
Video de ejemplo
Prompt original de generación
Create a 15-second, 16:9 cinematic promotional film with photorealistic materials and one continuous shot. A boutique flower shop occupies a high-rise terrace above a sea of clouds at blue hour. Small amber lights illuminate a wooden workbench, plain ceramic vases, and ivory flowers. Soft foreground petals partly conceal the view. Only a hint of the clouds and distant city lights is visible at first; save the wide reveal for the ending.

The florist is an adult East Asian woman around 28, with short dark hair, a smoky-gray linen apron, and a cream shirt. Her manner is calm and confident. From 0 to 2 seconds, the camera slides gently past the foreground petals. She places one ivory flower into a vase. Its center begins to emit a subtle warm glow, no brighter than a small night-light, casting believable light on her fingertips. The flower retains its physical botanical shape; it does not dissolve or become particles.

From 2 to 12.5 seconds, settle into a steady eye-level medium shot with her face and mouth clearly visible. Looking into the lens, she speaks in warm, clear English: “This flower shop above the clouds began as words. I brought it to life with Grok one point five text-to-video on Kinovi.” She briefly glances at the flower, then returns her gaze to the camera. All speech comes directly from the visible woman, with accurate lip sync and natural pauses, not from an off-screen narrator.

From 12.5 to 15 seconds, after the dialogue, slowly pull back to reveal the cloud-filled skyline beyond the terrace. Keep the florist and shop within the composition and settle on a quiet, complete final image.

Soft side lighting, realistic skin, tactile wood and linen, restrained deep-blue and warm-gold color contrast. The glowing flower center is the only close-range magical effect. Clear voice, a delicate stem-against-ceramic sound, faint high-altitude wind, and a very quiet atmospheric music bed beneath the dialogue. No subtitles, titles, readable signs, logos, or added text. Avoid frantic cuts, exaggerated acting, heavy bloom, floating particles, and complicated hand gestures.
Qué muestra la salida
El paisaje de nubes ya es visible al inicio. La florista coloca la flor luminosa en un jarrón, mira a la cámara durante la sección intermedia y permanece a la vista mientras la cámara se aleja para revelar más de la mesa de trabajo y la tienda. El entorno azul frío y la flor cálida establecen un foco visual claro.
El resultado no sigue cada detalle al pie de la letra. El prompt reserva la revelación amplia de las nubes para el final, pero gran parte del fondo es visible desde el inicio. El resplandor también se extiende por los pétalos en lugar de quedarse en el centro de la flor. La idea creativa general se transmite, con desviaciones en las instrucciones de revelación e iluminación.
Dónde encaja este enfoque
Una dirección útil para conceptos promocionales, ubicaciones imaginadas y planos de historia de marca. Organizar un prompt en entorno, acción, diálogo y composición final facilita evaluar el resultado.
2. Standard image-to-video: entrar en la playa dentro de una fotografía
Este ejemplo suministra un inicio y un destino claros: una fotógrafa junto a un caballete en la imagen de inicio, y una playa al atardecer en la imagen final. La tarea es conectar esos espacios, animar las olas dentro de la fotografía y mover la cámara hacia la escena costera.
Modo: Standard image-to-video
Entrada: El par de fotogramas suministrado se muestra abajo: el retrato de estudio como fotograma de inicio y la costa al atardecer como fotograma final.
Archivo: aproximadamente 6 segundos · 848 × 480 · 24 fps · pista de audio presente
Video de ejemplo
Imágenes de entrada
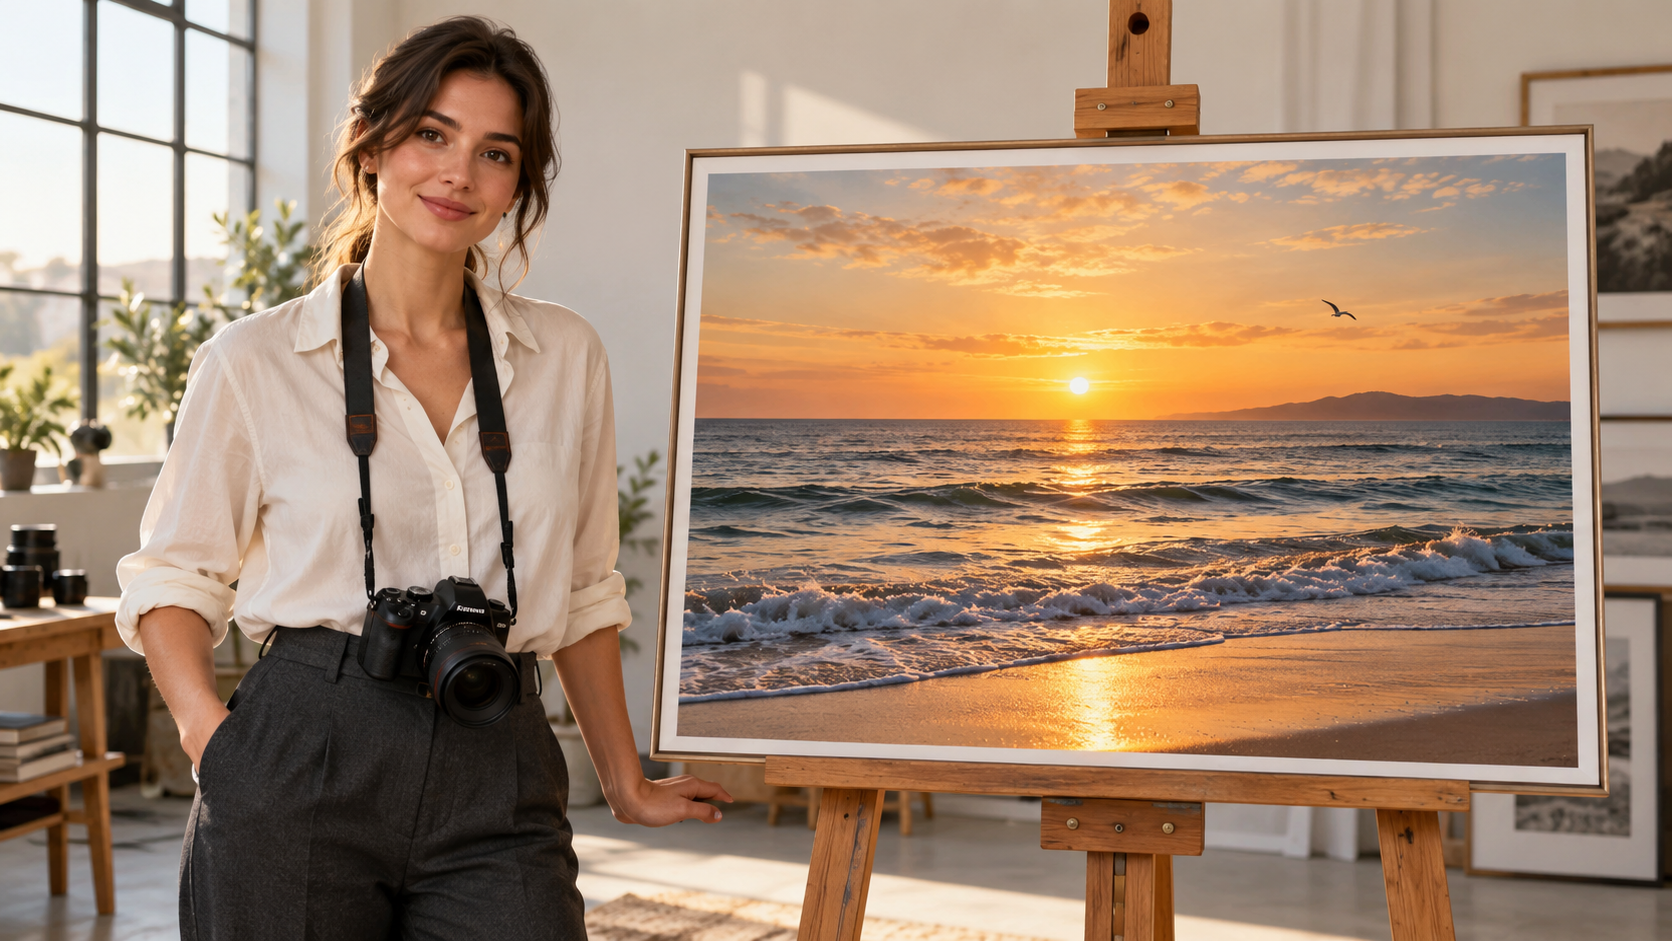
Fotograma de inicio: fotógrafa y paisaje marino enmarcado
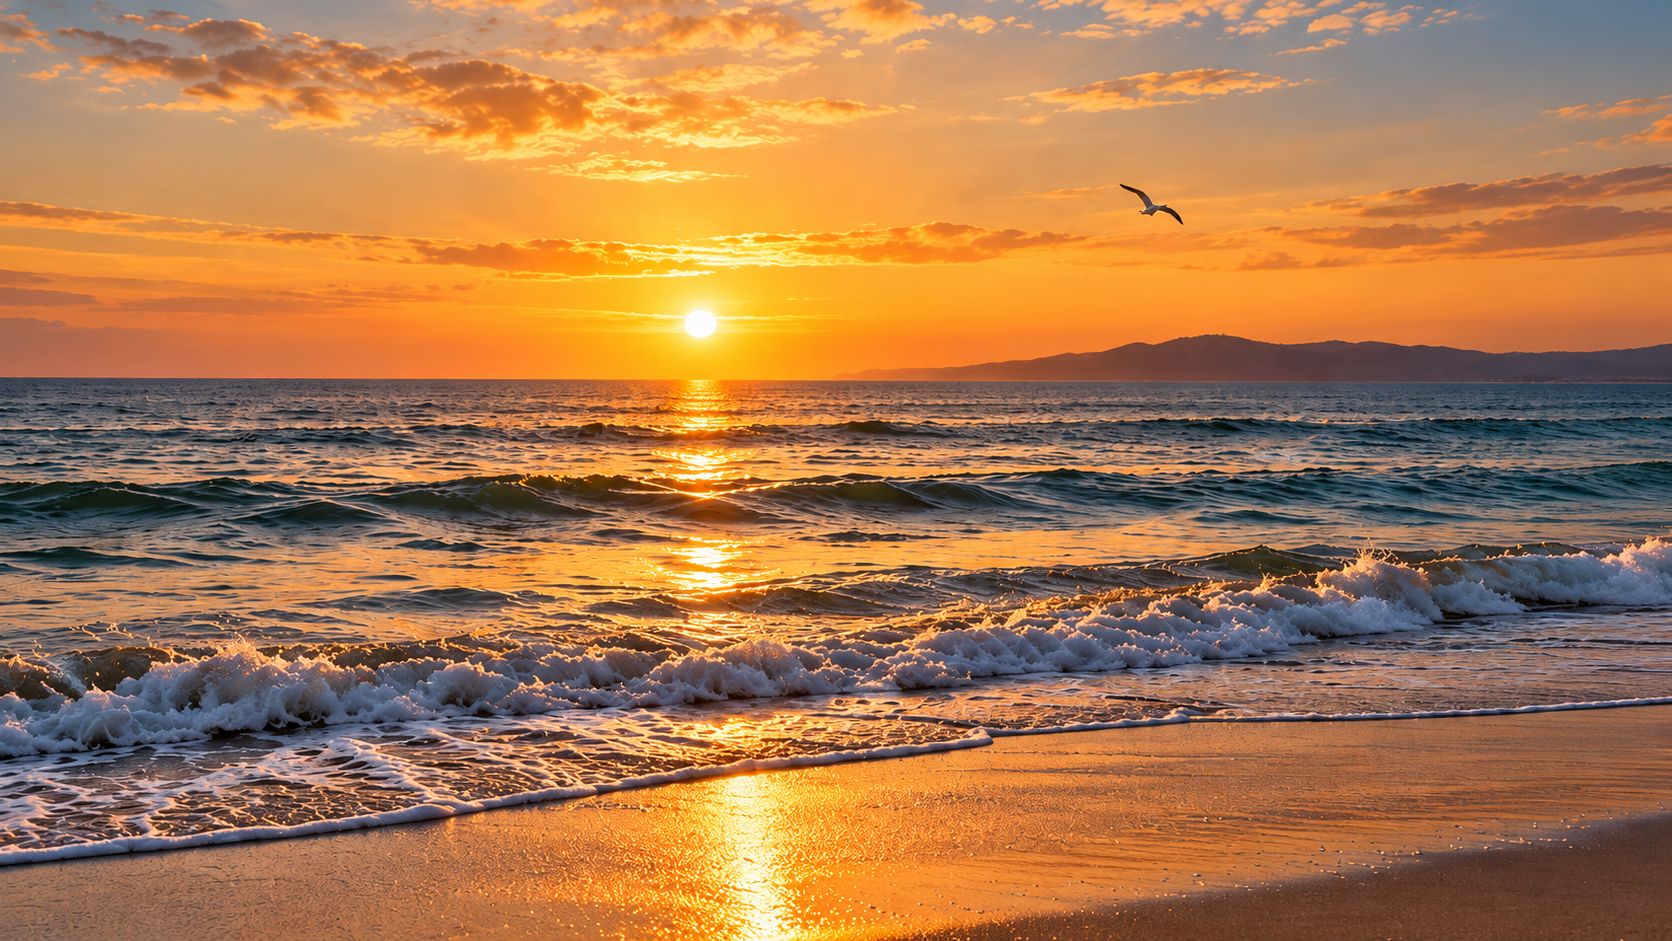
Fotograma final: costa al atardecer
Prompt original de generación
Photorealistic cinematic style, set in a modern photography studio. A young adult female photographer stands beside an easel displaying a photograph of a beach at sunset. She looks at the photograph, then turns toward the camera and smiles. She speaks in English:
“Let’s bring this photo to life! I made this on Kinovi using the grok-imagine-video-1.5 image-to-video model.”
As she gently gestures toward the photograph, the camera slowly pushes in. The waves within the photograph begin to roll naturally, sunlight shimmers across the water, and a seagull flies through the scene. The photograph’s frame gradually moves out of view until the moving seaside scene fills the entire screen. Natural gestures, accurate lip synchronization with the English dialogue, soft lighting, and a seamless transition. Clear voice audio accompanied by gentle ocean sounds. No added subtitles.
Qué muestra la salida
En la salida de aproximadamente seis segundos, la fotógrafa sonríe, mueve la boca y gesticula hacia la imagen. La cámara se acerca al marco mientras las olas cambian; al final, el estudio y el marco de la foto han salido de vista y el mar llena la pantalla. La transición entre las dos composiciones suministradas es visible en el resultado.
Este clip ilustra continuidad visual de fotograma a fotograma. El prompt también pide una línea en inglés, pero el movimiento de la boca por sí solo no establece que se pronunció toda la oración ni que se sincronizó palabra por palabra. Con un tiempo de ejecución tan corto, la completitud del diálogo debe verificarse por separado.
Dónde encaja este enfoque
Un enfoque útil para animación de fotos, visuales de viaje y transiciones hacia un mundo fotografiado. Define la conexión prevista entre los dos fotogramas y deja tiempo suficiente tanto para el movimiento de cámara como para el habla.
3. Standard reference-to-video: combinar un reloj, un pedestal y una habitación
Reference-to-video puede reunir en una sola escena activos separados de producto, exhibición y ubicación. Este concepto de reloj asigna un rol a cada imagen y luego solicita un primer plano de la esfera, una vista alrededor de la caja y un plano final más amplio.
Modo: Standard reference-to-video
Entrada: Sube en este orden: IMAGE_0 reloj, IMAGE_1 pedestal de mármol, IMAGE_2 interior. Las etiquetas del prompt se refieren a ese mismo orden.
Archivo: aproximadamente 8 segundos · 752 × 416 · 24 fps · pista de audio presente
Video de ejemplo
Imágenes de entrada
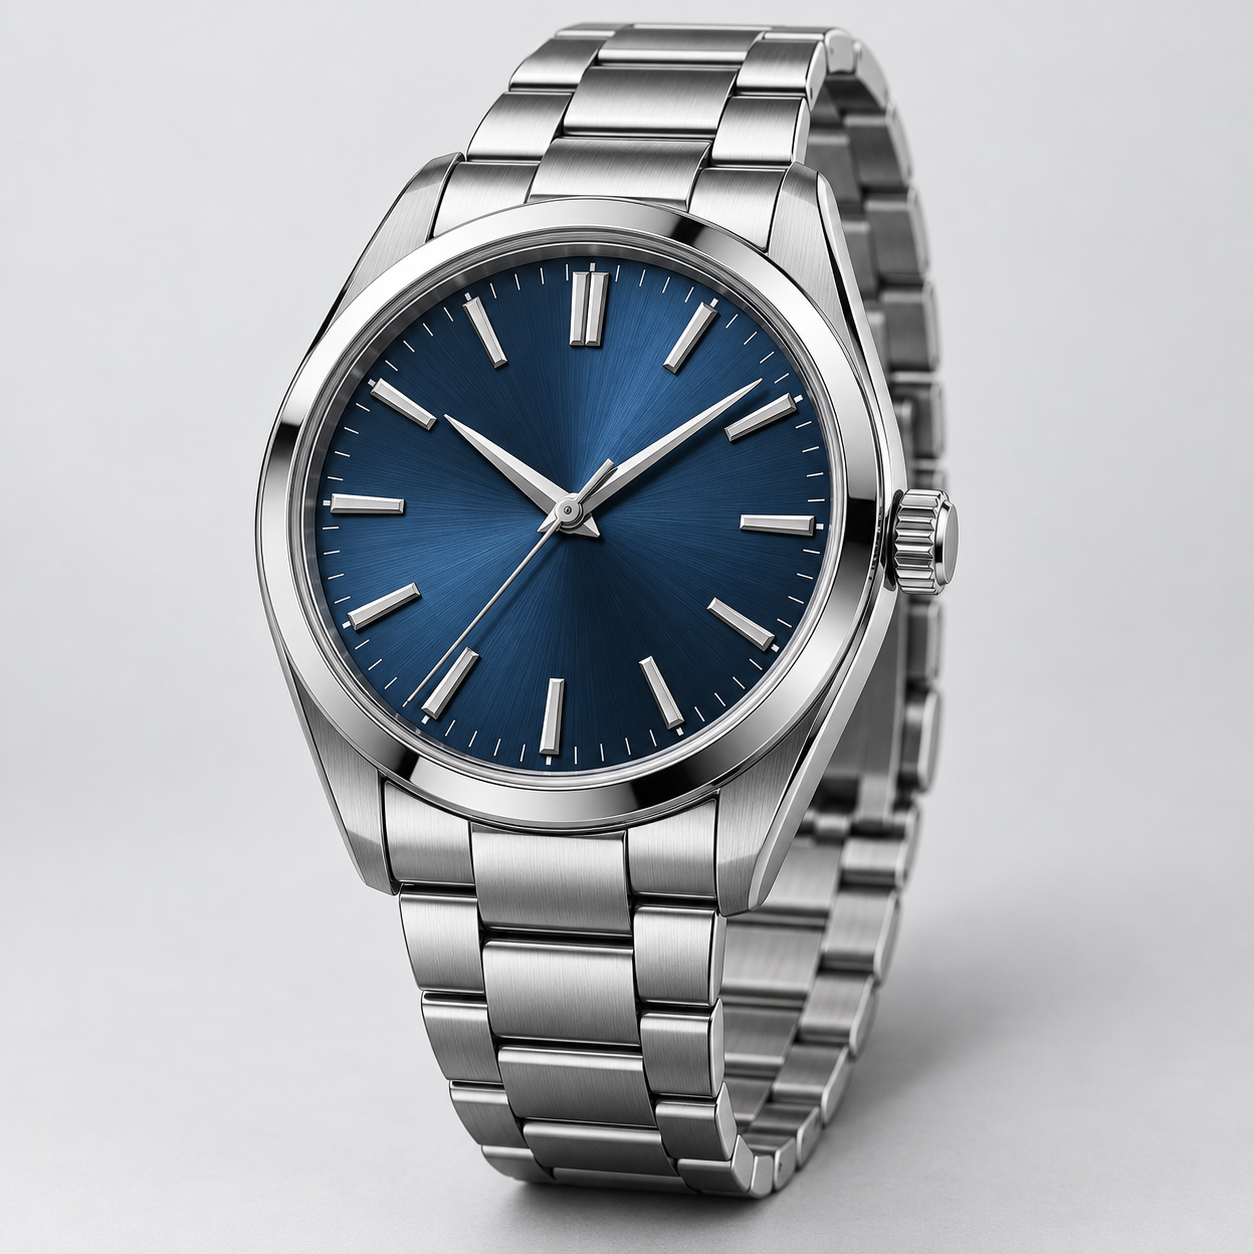
IMAGE_0: caja plateada y esfera azul
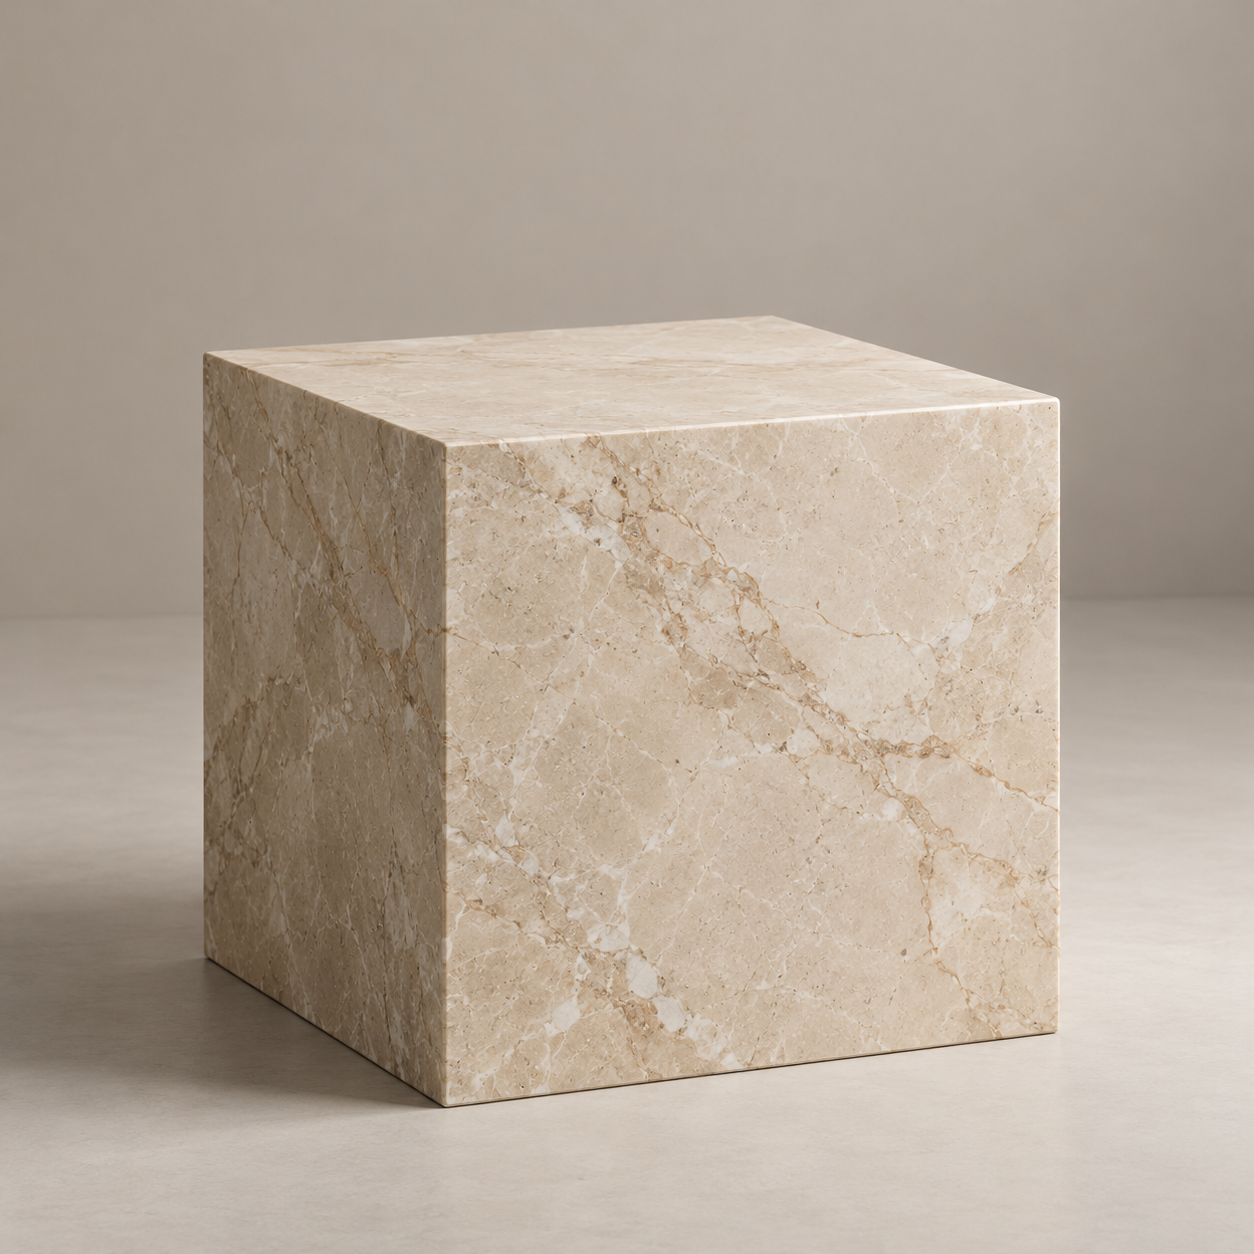
IMAGE_1: pedestal de mármol beige
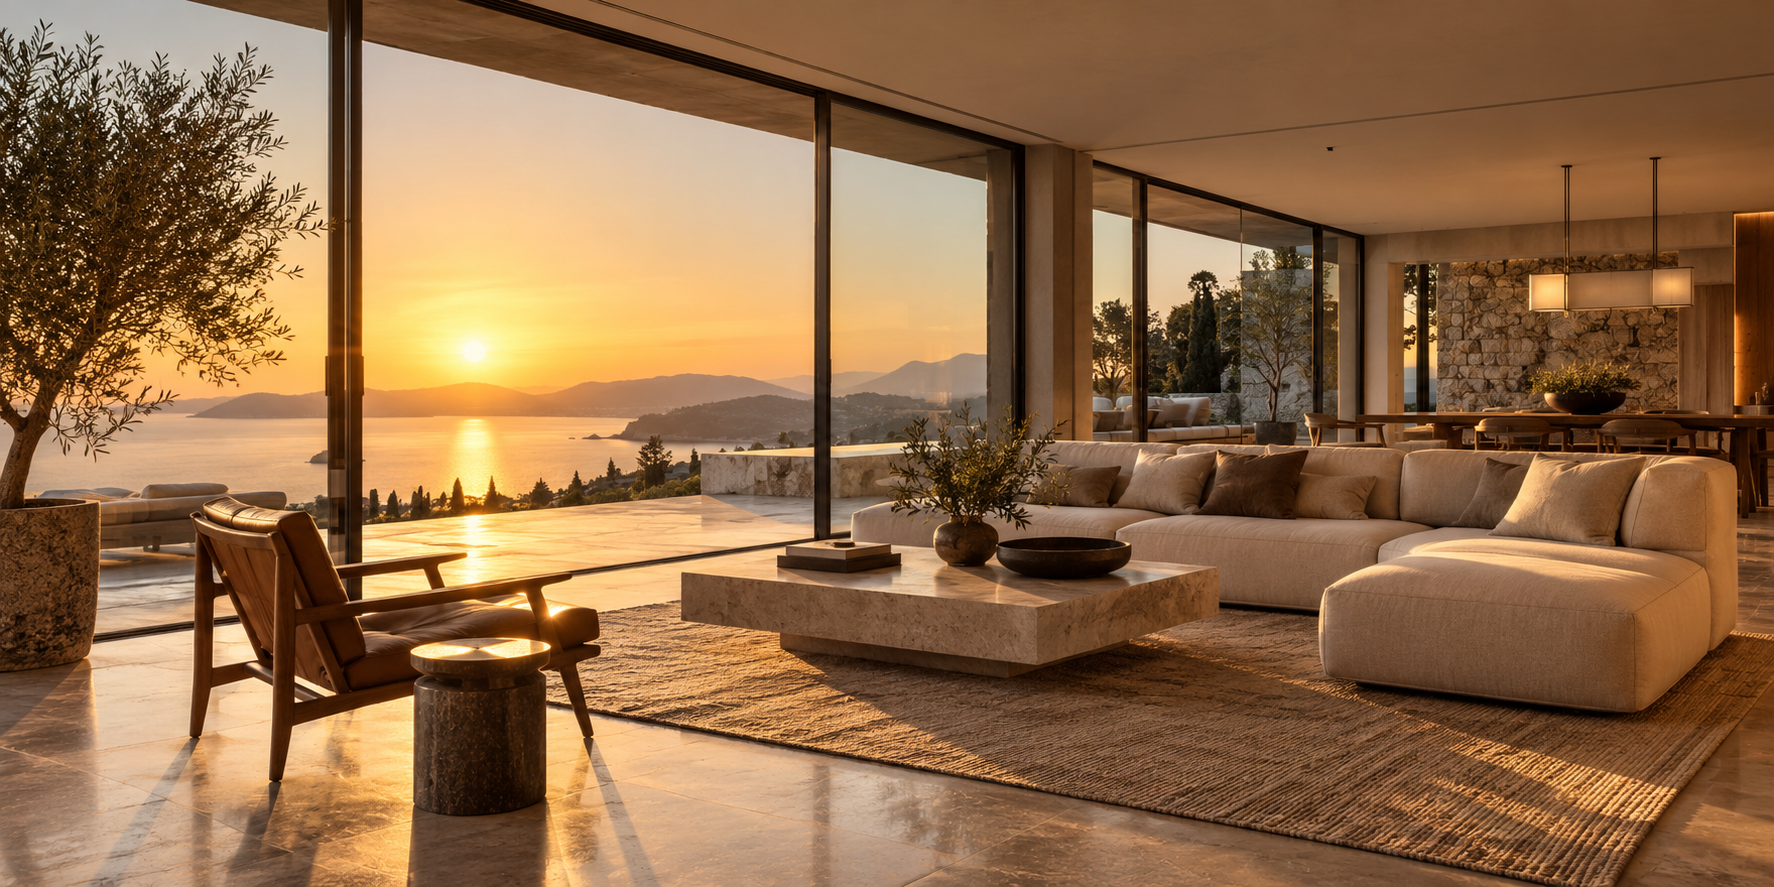
IMAGE_2: interior en hora dorada
Prompt original de generación
Create an 8-second luxury watch commercial by combining three reference images.

<IMAGE_0> is the exact watch product reference. Preserve its silver metal case, blue dial, hands, hour markers, crown placement and bracelet design.
<IMAGE_1> defines the beige marble pedestal and its surface texture.
<IMAGE_2> defines the warm golden-hour interior environment and lighting.

Place the exact watch from <IMAGE_0> upright on the marble pedestal from <IMAGE_1>, inside the setting from <IMAGE_2>.

0–2s: Extreme close-up of the watch dial. Fine metallic reflections reveal the watch's craftsmanship.

2–5s: The camera performs a slow cinematic orbit around the watch, revealing the case thickness, crown and metallic bracelet without altering their original geometry.

5–8s: The camera pulls back to reveal the watch resting on the marble pedestal, with warm sunlight and realistic shadows across the surface.

Maintain exact watch identity and material details throughout. Physically accurate metal reflections, consistent dial markings, realistic contact shadows and correct perspective.

Audio: Subtle mechanical ticking, luxurious ambient music and a gentle final musical accent.

No added logos, no invented text, no product redesign. 16:9.
Qué muestra la salida
La salida abre cerca de la esfera azul, revela la corona, la caja y el brazalete, y luego se aleja para mostrar el reloj de pie sobre una superficie de mármol. Los tres ingredientes principales —el producto, la exhibición y el interior cálido— están representados.
El producto, sin embargo, no es una réplica exacta. El reloj suministrado no tiene ventana de fecha, mientras que el primer plano generado introduce una función de ventana de fecha/lupa. El ejemplo demuestra composición multiimagen y diseño de planos comerciales; no establece fidelidad perfecta del producto. Los detalles de la esfera, los marcadores, la colocación de la corona y la estructura del brazalete necesitan una revisión separada antes de usarlo en un anuncio de producto.
Dónde encaja este enfoque
Útil para propuestas de puesta en escena de producto y conceptos publicitarios. Asigna roles explícitos a cada referencia e inspecciona los detalles del producto generado antes de tratar el clip como una demostración fiel del producto.
4. Lite text-to-video: lavar una luna a las 2 a. m.
Un astronauta, una lavandería y una luna comparten un solo escenario. El personaje permanece casi quieto, mientras la cámara, el tambor y el agua aportan movimiento alrededor de un punto focal surrealista.
Modo: Lite text-to-video
Entrada: Solo texto; sin imágenes de referencia.
Archivo: aproximadamente 8 segundos · 848 × 480 · 24 fps · pista de audio presente
Video de ejemplo
Prompt original de generación
An 8-second cinematic shot inside a quiet, slightly worn neighborhood laundromat at 2 a.m. Rain streaks the storefront windows. A single astronaut sits motionless on a plastic chair, holding an empty laundry basket.

Inside the oversized circular window of the central washing machine, a luminous three-dimensional moon slowly rotates like a heavy object in a wash cycle. Its craters remain clearly visible. A thin ring of water slides around the bottom of the drum, catching silver moonlight.

The camera makes one slow, deliberate push toward the machine. Its warm interior glow gently illuminates the astronaut's visor and the scratched tile floor, contrasting with the cool fluorescent ceiling lights.

Treat this impossible scene with understated photographic realism: restrained colors, tactile surfaces, subtle film grain, controlled highlights. The moon stays inside the drum throughout. One continuous shot, no cuts.

Audio: a low mechanical hum, water softly sloshing, distant rain. No dialogue or music.
Qué muestra la salida
La cámara se acerca mientras el astronauta se sienta sosteniendo una canasta. La luna brillante permanece dentro del tambor sobredimensionado, y su luz cálida se refleja en el piso húmedo. La composición transmite con claridad la idea de esperar a que una luna termine su lavado.
La salida también agrega agua que se derrama del tambor y se acumula en el piso, yendo más allá del delgado anillo de agua dentro de la máquina que pedía el prompt. Los cambios en la superficie de la luna no bastan por sí solos para verificar una rotación tridimensional físicamente consistente. Establece la idea visual y también muestra cómo el modelo puede elaborar detalles.
Dónde encaja este enfoque
Una dirección para explorar en ideación visual con presupuesto limitado, planos atmosféricos y clips para redes. Esta escena difiere del ejemplo de text-to-video estándar, por lo que no es una comparación controlada de su calidad.
5. Lite image-to-video: dar a un retrato de moda un sentido de vida
La referencia de inicio seleccionada coincide con el traje marfil y el entorno de terraza de la salida. La persona, el atuendo, la silla, la pared y la cortina transparente ya están definidos, así que el video se centra en pequeños movimientos faciales, el cabello y la tela.
Modo: Lite image-to-video
Entrada: Una imagen de inicio: una mujer sentada con un traje marfil en una terraza.
Archivo: aproximadamente 15 segundos · 736 × 400 · 24 fps · pista de audio presente
Video de ejemplo
Imágenes de entrada
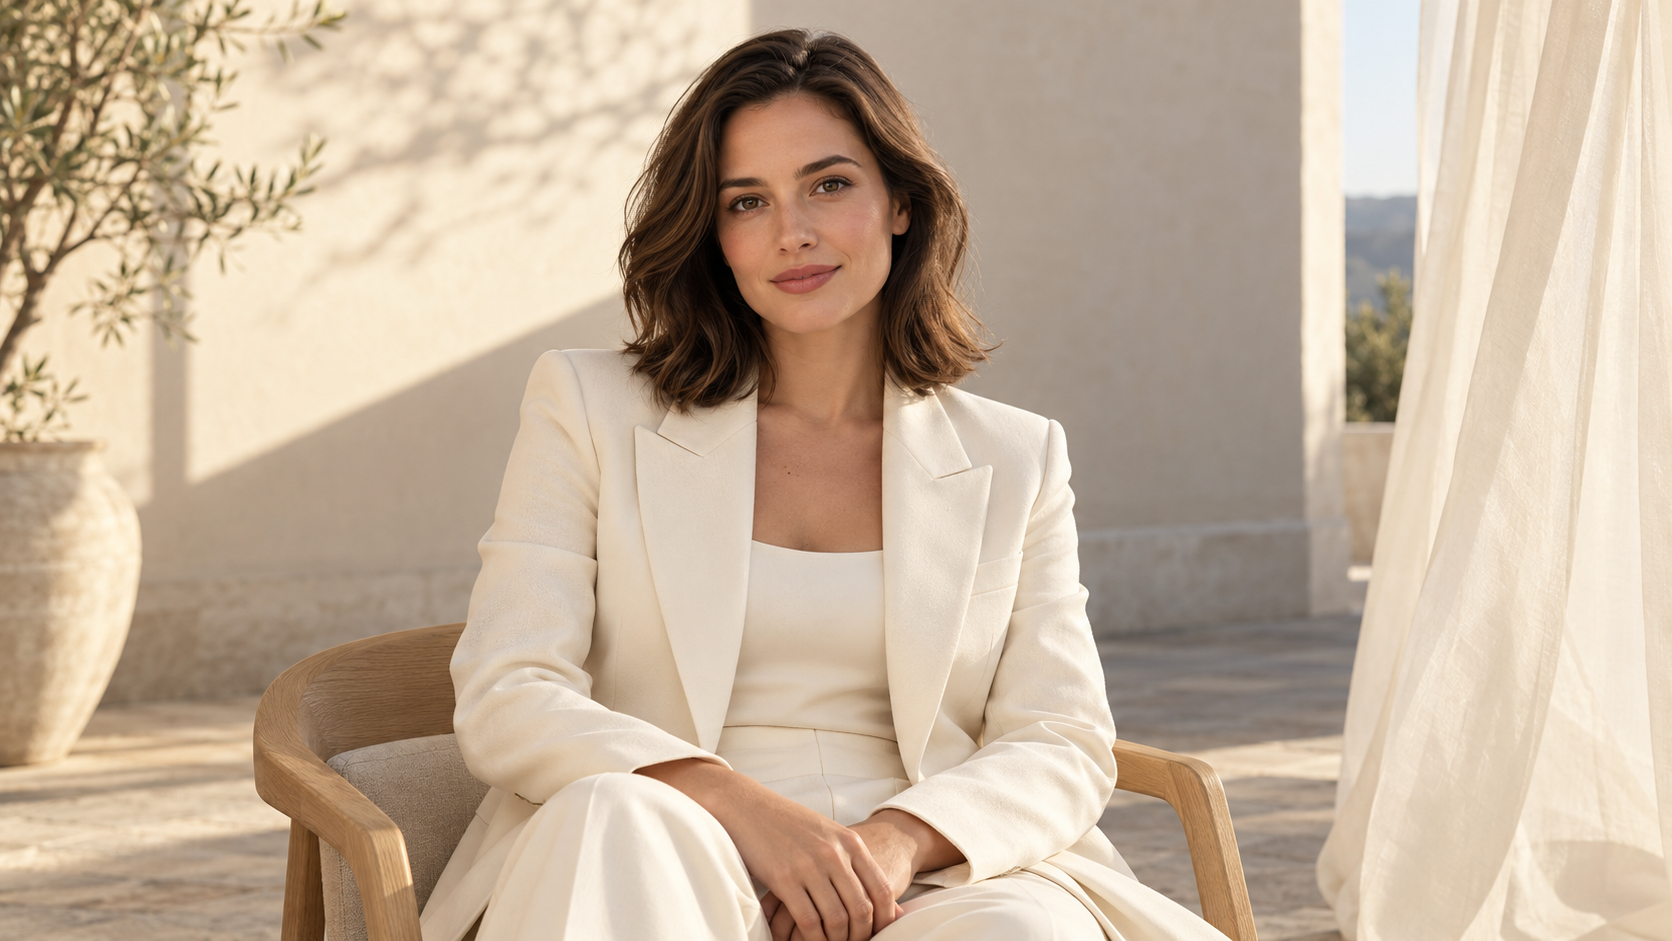
Fotograma de inicio: retrato en terraza con traje marfil
Prompt original de generación
Use the uploaded portrait as the first frame of a 15-second, 16:9 premium fashion talking-portrait film. Preserve the adult woman’s identity, hairstyle, ivory suit, seated pose, chair, architectural terrace, warm-white wall, sheer curtain, and original composition. Use a locked, eye-level medium shot. Do not change her outfit, location, or identity.

From 0 to 2 seconds, begin naturally from the input image. A gentle breeze moves a few strands of hair beside her ear and the translucent ivory curtain at the side of the frame. Keep the curtain near the image edge, never over her face. She blinks softly, with subtle, natural breathing through her shoulders.

From 2 to 12.5 seconds, she looks into the lens and speaks in composed, confident English: “A portrait can have a cinematic sense of life. I made this with Grok one point five Lite image-to-video on Kinovi.” Her delivery feels like a model sharing a creative moment after a shoot, not a loud sales pitch. Use clear diction and natural pauses. The visible woman speaks the entire line with accurate lip sync. Keep her hands relaxed and use only small eye and head movements; no waving.

From 12.5 to 15 seconds, after the dialogue, she briefly looks toward the sunlight at the side and returns to the camera with a faint smile. The hair and curtain continue moving gently. Hold the camera still and end on the complete fashion-portrait composition.

Champagne-colored side light, soft geometric shadows, realistic skin and suit fabric, and layered, restrained warm whites. No excessive beauty filtering, plastic skin, or strong lens flares. Clear speech, gentle wind, and a very quiet original sparse-piano bed beneath the voice. No off-screen narration, subtitles, magazine cover text, logos, or added on-screen lettering. Maintain stable facial features and clothing. No large head turns or curtain passing through the body.
Qué muestra la salida
El clip de aproximadamente 15 segundos se mantiene centrado en la sujeto sentada. El traje marfil, la silla y el entorno blanco cálido siguen siendo reconocibles en los fotogramas muestreados. Su boca y expresión cambian, la cortina se mueve y el final vuelve a una expresión más quieta.
El clip ilustra una animación sutil de un retrato existente. La ropa y el entorno reconocibles no establecen una preservación de identidad perfecta fotograma a fotograma. La completitud del diálogo, la pronunciación y la sincronización audiovisual también necesitan su propia revisión en reproducción.
Dónde encaja este enfoque
Una configuración útil para presentaciones personales, animación de retratos de moda y contenido de talking-head contenido. Una imagen de inicio clara y un conjunto pequeño de movimientos facilitan definir el resultado previsto.
4. Empieza a crear en Kinovi
- Elige el modo de entrada. Usa text-to-video para una idea, image-to-video para una composición existente o reference-to-video para varios activos visuales.
- Prepara el material. Haz que la imagen de inicio sea clara y que la imagen final sea intencional. Para referencias, mantén el orden de carga consistente y asigna un rol a cada imagen en el prompt.
- Define la duración y la calidad de salida. Deja tiempo tanto para el habla como para el movimiento de cámara. Revisa la resolución, el audio, los ajustes de encuadre admitidos y el precio actual.
- Revisa lo que importa al proyecto. Comprueba rostros, manos y movimiento labial en personas; geometría, tipografía y materiales en productos; y el inicio, el final y el movimiento intermedio en transiciones.
Abrir una opción de generación
- Standard text-to-video
- Standard image-to-video
- Standard reference-to-video
- Lite text-to-video
- Lite image-to-video
5. La conclusión: elige primero el flujo de trabajo y luego evalúa la versión
Los cinco videos parten de tipos distintos de material. La florería construye una escena desde texto; el clip de estudio conecta dos composiciones; el comercial de reloj combina referencias; la lavandería de la luna explora un concepto surrealista a la tarifa listada más baja de Lite; y el retrato de moda extiende un personaje y un entorno existentes.
Empieza por la tarea. Para múltiples referencias o un fotograma final, revisa la opción estándar correspondiente. Para ideas basadas en texto o animación de una sola imagen, incluye Lite en tus pruebas. Luego compara salidas de la misma tarea para decidir si el detalle, la calidad visual y el costo cumplen tus necesidades.
Un ambiente convincente no significa que se siguiera cada instrucción, y un comercial atractivo no garantiza un producto preciso. Un flujo de trabajo útil deja espacio tanto para la generación creativa como para una revisión cuidadosa antes de la publicación.
6. Preguntas frecuentes
1. ¿Son estos cinco modelos completamente separados?
Una forma más útil de navegarlos es como dos versiones —estándar y Lite— con distintos modos de entrada. Kinovi los lista como opciones separadas para que los creadores puedan elegir por tarea.
2. ¿En qué se diferencian image-to-video y reference-to-video?
Image-to-video parte de una composición específica; la opción estándar también puede tomar un fotograma final. Reference-to-video usa imágenes para definir sujetos, productos o entornos sin tratar automáticamente la primera referencia como un fotograma de apertura fijo. Uno extiende una composición; el otro combina fuentes visuales.
3. ¿Pueden los videos incluir habla y audio ambiental?
Las cinco opciones exponen generación de audio. Los prompts pueden pedir diálogo, ambiente, efectos y música, pero la completitud del habla, la pronunciación y la sincronización deben verificarse en la salida. Las líneas más largas necesitan suficiente tiempo de ejecución.
4. ¿Todos los modos admiten 1080p y fotogramas de inicio/final?
No. Text-to-video e image-to-video estándar y Lite listan 1080p, mientras que reference-to-video llega hasta 720p. Image-to-video estándar se limita a 720p cuando se usa un fotograma final. Lite image-to-video acepta una sola imagen de inicio, y su salida 1080p es upscaled.
5. ¿Lite es más rápido o igual en calidad que el estándar?
Estos ejemplos no incluyen registros comparables de tiempo de generación ni tareas emparejadas, por lo que no establecen paridad de velocidad o calidad. Este artículo tampoco equipara Lite con la versión Fast del anuncio de xAI.
6. ¿Cómo estimo el costo?
Multiplica la tarifa actual por segundo de la opción y resolución elegidas por la duración de la salida. Revisa los términos aplicables de reintento, fallo y promociones. Un archivo de video de muestra por sí solo no establece el monto cobrado por su generación.
7. ¿Las referencias garantizan un producto sin cambios?
Este ejemplo no respalda esa garantía. La salida del reloj agrega una función de ventana de fecha/lupa ausente en la referencia. Para marketing de producto, inspecciona la esfera, la tipografía, la geometría y los detalles estructurales antes de aprobar el resultado.
8. ¿Se seguirán las instrucciones de sincronización del prompt al segundo exacto?
Los rangos de tiempo comunican el ritmo, pero no son una línea de tiempo de edición precisa. Los ajustes reales de generación determinan el tiempo disponible, y el modelo puede revelar un fondo antes de tiempo o elaborar un efecto. Prioriza el habla y las acciones esenciales.
Fuentes y notas de verificación
Las especificaciones y tarifas de las plataformas se verificaron el 21 de octubre de 2026. Las asignaciones de modelos, los prompts y las imágenes de entrada siguen el material del caso suministrado; las duraciones y dimensiones de salida se leyeron de los archivos. Los videos originales no se han editado, doblado ni subtitulado para este artículo. Los ejemplos ilustran flujos de trabajo en lugar de establecer un ranking general de modelos.
Artículos relacionados
More to try
Modelos relacionados
ByteDance · video model
Seedance 2.0
Modelo de video con IA de próxima generación de ByteDance. Combina los modos Fast y Pro para generar videos de alta calidad.
$0.0707/s
Alibaba · video model
HappyHorse 1.0
HappyHorse 1.0 es el modelo de generación de video de alta calidad de Alibaba disponible en Kinovi. Admite texto a video, imagen a video, video con imágenes de referencia y edición de video.
$0.0801/s
OpenAI · image model
GPT Image 2
Modelo avanzado de generación y edición de imágenes con IA de OpenAI. Comprende conceptos complejos y genera imágenes detalladas y realistas a partir de texto.
$0.0100/image