2026年 Kinovi上のGrok Imagine Video 1.5:クリエイティブ映像から商品広告まで、5つの選択肢
オリジナルプロンプトと参照画像付きの実例動画5本に加え、Kinovi上のGrok Imagine Video 1.5およびLiteの仕様・料金・FAQをまとめます。
ひと目でわかるポイント: 雲の上の花屋、写真の中から動き出すビーチ、3枚のビジュアル参照から組み立てた腕時計CM。Grok Imagine Video 1.5ファミリーは、Kinovi上で標準版とLiteあわせて5つのオプションとして利用できます。本ガイドでは、既存の5本の動画、入力画像、完全なプロンプト、仕様、現時点の料金をまとめ、ご自身のプロジェクトの出発点を選びやすくします。
AI動画プロジェクトは、すでに手元にある素材から始まることが少なくありません。文章のアイデアには世界観の構築が必要です。写真には動きが必要です。商品・ディスプレイ・ロケーションの別々の画像は、ひとつのショットにまとめなければなりません。
以下の例は、標準のテキストから動画、標準の画像から動画、標準の参照から動画、Liteのテキストから動画、Liteの画像から動画、という順に並んでいます。それぞれが異なる創作タスクを示します。シーン・尺・入力が異なるため、標準とLiteの厳密な優劣比較ではなく、ショーケースとしてご覧ください。
1. Grok Imagine Video 1.5はワークフローに何をもたらすか?
xAIのローンチ発表では、動き・物理・オーディオの改善が強調されており、より一貫した動きや、アクションにより合う効果音・環境音・台詞が含まれます。これらはプロバイダー側の説明であり、以下の例は具体的な創作タスクで何が起きたかを示します。公式発表。
Kinoviでは、5つのオプションが3つの入力モードと2つのバージョンにまたがります。
- テキストから動画(Text-to-video): コンセプトショット、物語の冒頭、プロモーション案など、文章の説明からシーンを構築します。
- 画像から動画(Image-to-video): 既存の画像から始めます。標準オプションは終了フレームも受け付けます。Liteは開始画像1枚を使います。
- 参照から動画(Reference-to-video): 複数の画像でキャラクター・商品・環境を指定しながら、新しいショットを構成します。このモードは現時点でKinoviの標準オプション経由で提供されています。
標準とLiteの選択には、料金と機能の両方が関わります。Liteは掲載レートが低めです。複数のビジュアル参照や終了フレームなどの要件は、バージョン名より先に入力モードの選択を導くべきです。
2. 仕様と現時点の料金
以下の情報は、2026年10月21日にKinoviのモデルページと照合済みです。各オプションは詳細ページへリンクしています。
| オプション | 入力 | 尺 | 出力解像度 | 主な違い |
|---|---|---|---|---|
| Standard text-to-video | テキスト | 1–15秒 | 480p / 720p / 1080p | テキストからシーンを構築 |
| Standard image-to-video | 開始画像;終了画像は任意 | 1–15秒 | 480p / 720p / 1080p | 終了画像ありの場合は最大720p |
| Standard reference-to-video | 参照画像1–7枚とテキスト | 1–15秒 | 480p / 720p | ビジュアル参照を組み合わせ |
| Lite text-to-video | テキスト | 1–15秒 | 480p / 720p / 1080p | 掲載レートが低め |
| Lite image-to-video | 開始画像1枚;テキストは任意 | 1–15秒 | 480p / 720p / 1080p | 単一画像をアニメーション化 |
5つのオプションすべてがオーディオトラックに対応し、4,000文字のプロンプト上限を公開しています。テキストから動画と参照から動画は複数のアスペクト比に対応します。単一画像のアニメーションは、入力画像とオプション側のフレーミング挙動に従います。標準の画像から動画のアスペクト比パラメータは、終了画像が提供された場合にのみ使用されます。
同じ出力解像度ラベルでも、レンダリング工程が同じとは限りません。xAIの現行ドキュメントでは、標準のテキストから動画と画像から動画はネイティブ1080pに対応し、Liteは720pをアップスケールして1080pに到達すると説明されています。公式動画ドキュメント。
生成動画1秒あたりの料金
以下の金額はすべて、結果待ちの秒数ではなく、出力動画1秒あたりのUSDです。
| オプション | 480p | 720p | 1080p |
|---|---|---|---|
| Standard text-to-video | $0.0501 | $0.0878 | $0.1567 |
| Standard image-to-video | $0.0501 | $0.0878 | $0.1567 |
| Standard reference-to-video | $0.0501 | $0.0878 | 非対応 |
| Lite text-to-video | $0.0125 | $0.0188 | $0.0878 |
| Lite image-to-video | $0.0125 | $0.0188 | $0.0878 |
たとえば、現行の720pレートでは、8秒の標準クリップは 8 × $0.0878 = $0.7024、8秒のLiteクリップは 8 × $0.0188 = $0.1504 です。これらは説明用の計算であり、下記クリップの実際の請求額ではありません。価格関係は解像度ごとに変わるため、単一の節約比率をすべてのティアに当てはめるべきではありません。
標準のテキストから動画と画像から動画のページでは、料金が Preview test pricing(プレビューテスト料金) と表示されています。送信時に表示される金額と、選択したオプションに適用される失敗・返金条件を確認してください。
Grok Imagine Video 1.5:プラットフォーム横断の料金比較
この比較は 標準のGrok Imagine Video 1.5のみ を対象とし、Liteおよび旧モデルは除外します。2026年10月21日時点で確認。解像度列は、メンバーシップ換算・ボーナスクレジット・サブスクリプション割引を含まない、公開の従量料金として 出力動画1秒あたりのUSD を示します。料金ソースは表の下に記載しています。
| プラットフォーム | 480p | 720p | 1080p | 追加の入力画像料金 | 料金の適用範囲 |
|---|---|---|---|---|---|
| Kinovi | $0.0501 | $0.0878 | $0.1567(テキスト/画像) | ページ上で明細なし;送信時に確認 | テキストと画像;参照から動画は最大720p |
| Kie | ≈ $0.012 | ≈ $0.0225 | 公開レート未検証 | ページ上で明細なし;送信時に確認 | 画像から動画ページに掲載の1.5 Preview料金 |
| Higgsfield | $0.08 | $0.14 | $0.25 | 別途課金は未検証 | 1.5 APIモデルファミリー料金;下記のモード条件を参照 |
| fal | $0.08 | $0.14 | $0.25(テキスト/画像) | 入力画像1枚あたり $0.01 | テキストと画像;参照から動画は最大720p |
| Segmind | $0.108 | $0.189 | $0.3375(テキスト/画像) | 入力画像1枚あたり $0.0135 | テキストと画像;参照から動画は最大720p |
| WaveSpeed | $0.08 | $0.14 | $0.25(テキスト/画像) | 単一画像モード:$0.01/リクエスト;参照モード:$0.01/画像 | テキストと画像;参照から動画は最大720p |
| xAI official | $0.08 | $0.14 | $0.25(テキスト/画像) | 入力画像1枚あたり $0.01 | テキストと画像;参照から動画は最大720p |
料金ソース: Kinovi · RunningHub · Kie · Higgsfield · fal · Segmind · WaveSpeed · xAI official
比較に影響する条件:
- Kinovi: 標準のテキストから動画と画像から動画は、掲載のPreview test pricingを使用します。参照モードの料金も Kinovi reference-to-videoページ で確認できます。明細のない画像料金をゼロとみなすべきではありません。
- RunningHub: カタログは
xai/grok-imagine-video-v1.5/.../stableの公式stableルートについて、解像度別なしで $0.08/s を掲載しています。この金額をすべてのティアに適用できません。別のxai/grok-imagine-v1.5/...economyルートは $0.03/s を示しますが、解像度料金と対応能力は未検証のため、ティア価格としてではなく別記とします。 - Kie: ページは
grok-imagine-video-1-5-previewを示し、480pと720pについて 2.4および4.5 credits/s を掲載しています。表ではボーナスクレジットなしの、ページ上のおおよそのドル換算を使っています。1080pは選択肢として表示されますが、価格は未検証です。他モデルの料金は代用しません。Preview表記と各プラットフォームのサービス条件は別途確認してください。 - Higgsfield: これらはクリエイター向けサブスクリプション換算ではなく、公開APIのモデルファミリー料金です。ページは480p/720pの1秒クリップと1080pの15秒クリップで料金を例示しています。すべての尺・参照モード・追加入力で同一条件とは限りません。
- モードと追加課金: 参照モードの解像度上限と画像料金は、fal reference-to-video、Segmind reference-to-video、WaveSpeed reference-to-video の各ページに記載されています。Segmind text-to-video料金ページ では表と説明文の金額が食い違います。本比較では明示の料金表を採用します。送信前に課金額を確認してください。
合計を見積もるには、開示された入力料金を動画生成料金に加算します。たとえば、xAI公式価格で 入力画像1枚付きの8秒・720pクリップ は 8 × $0.14 + $0.01 = $1.13 です。テキストのみの生成には入力画像料金はありません。「未検証」は「非対応」や「無料」を意味しません。これらの数値は予算の参考であり、送信時に表示される価格とサービス条件が優先されます。
3. 5つの例(モデル順)
各例には、提供された動画、該当する場合は入力画像、およびオリジナルの英語プロンプトが含まれます。プロンプト内の台詞やタイミング指示は意図した出力を記述したものであり、生成オーディオの逐語書き起こしではありません。ビジュアルのコメントはサンプリングしたフレームに基づき、ファイル詳細はメディアメタデータから取得しています。単語単位の音声やリップシンク測定は行っていません。
| 順 | オプション | 例 | おおよそのファイル尺 | ファイル寸法 |
|---|---|---|---|---|
| 1 | Standard text-to-video | 雲の上の花屋 | 15秒 | 848 × 480 |
| 2 | Standard image-to-video | 写真の中のビーチへ入る | 6秒 | 848 × 480 |
| 3 | Standard reference-to-video | 腕時計CM | 8秒 | 752 × 416 |
| 4 | Lite text-to-video | 月のコインランドリー | 8秒 | 848 × 480 |
| 5 | Lite image-to-video | ファッションポートレート | 15秒 | 736 × 400 |
これらは受け取ったファイルの寸法であり、モデルの最大能力や、すべての元送信設定の証明ではありません。5ファイルとも24 fpsで、オーディオトラックを含みます。
1. Standard text-to-video:雲の上の花屋
開始画像や参照アセットはありません。コンセプトはテキストから始まります。ブルーアワーの高層テラス、雲の上の花屋、温かい実用照明、花を整えるフローリスト。プロンプトはカメラ前の台詞、光る花、広い設定を見せる最終カメラ移動も指定しています。
Mode: Standard text-to-video
Input: テキストのみ;参照画像なし。
File: 約15秒 · 848 × 480 · 24 fps · オーディオトラックあり
Example video
Original generation prompt
Create a 15-second, 16:9 cinematic promotional film with photorealistic materials and one continuous shot. A boutique flower shop occupies a high-rise terrace above a sea of clouds at blue hour. Small amber lights illuminate a wooden workbench, plain ceramic vases, and ivory flowers. Soft foreground petals partly conceal the view. Only a hint of the clouds and distant city lights is visible at first; save the wide reveal for the ending.

The florist is an adult East Asian woman around 28, with short dark hair, a smoky-gray linen apron, and a cream shirt. Her manner is calm and confident. From 0 to 2 seconds, the camera slides gently past the foreground petals. She places one ivory flower into a vase. Its center begins to emit a subtle warm glow, no brighter than a small night-light, casting believable light on her fingertips. The flower retains its physical botanical shape; it does not dissolve or become particles.

From 2 to 12.5 seconds, settle into a steady eye-level medium shot with her face and mouth clearly visible. Looking into the lens, she speaks in warm, clear English: “This flower shop above the clouds began as words. I brought it to life with Grok one point five text-to-video on Kinovi.” She briefly glances at the flower, then returns her gaze to the camera. All speech comes directly from the visible woman, with accurate lip sync and natural pauses, not from an off-screen narrator.

From 12.5 to 15 seconds, after the dialogue, slowly pull back to reveal the cloud-filled skyline beyond the terrace. Keep the florist and shop within the composition and settle on a quiet, complete final image.

Soft side lighting, realistic skin, tactile wood and linen, restrained deep-blue and warm-gold color contrast. The glowing flower center is the only close-range magical effect. Clear voice, a delicate stem-against-ceramic sound, faint high-altitude wind, and a very quiet atmospheric music bed beneath the dialogue. No subtitles, titles, readable signs, logos, or added text. Avoid frantic cuts, exaggerated acting, heavy bloom, floating particles, and complicated hand gestures.
出力が示すもの
オープニング時点ですでに雲海が見えます。フローリストは光る花を花瓶に入れ、中盤はカメラに向き、引きでワークベンチと店のより広い範囲が現れるあいだも画面内に残ります。冷たい青の周囲と温かい花が、はっきりした視覚的焦点を作ります。
結果は細部まで字義どおりには従っていません。プロンプトは広い雲のリビールをエンディングに残すとしていますが、背景の多くは最初から見えています。光も花の中心に留まらず、花弁全体に広がります。大きな創作アイデアは伝わりつつ、リビールと照明の指示ではずれがあります。
このアプローチが合う場面
プロモーションコンセプト、想像上のロケーション、ブランドストーリーショットに有用な方向性です。プロンプトを設定・アクション・台詞・最終構図に整理すると、結果を評価しやすくなります。
2. Standard image-to-video:写真の中のビーチへ入る
この例は、明確な始まりと行き先を与えます。開始画像はイーゼルの横のフォトグラファー、終了画像は夕暮れのビーチです。タスクはそれらの空間をつなぎ、写真内の波を動かし、カメラを海岸シーンへ入れることです。
Mode: Standard image-to-video
Input: 下記のフレームペアを使用。スタジオポートレートが開始フレーム、夕暮れの海岸が終了フレームです。
File: 約6秒 · 848 × 480 · 24 fps · オーディオトラックあり
Example video
Input images
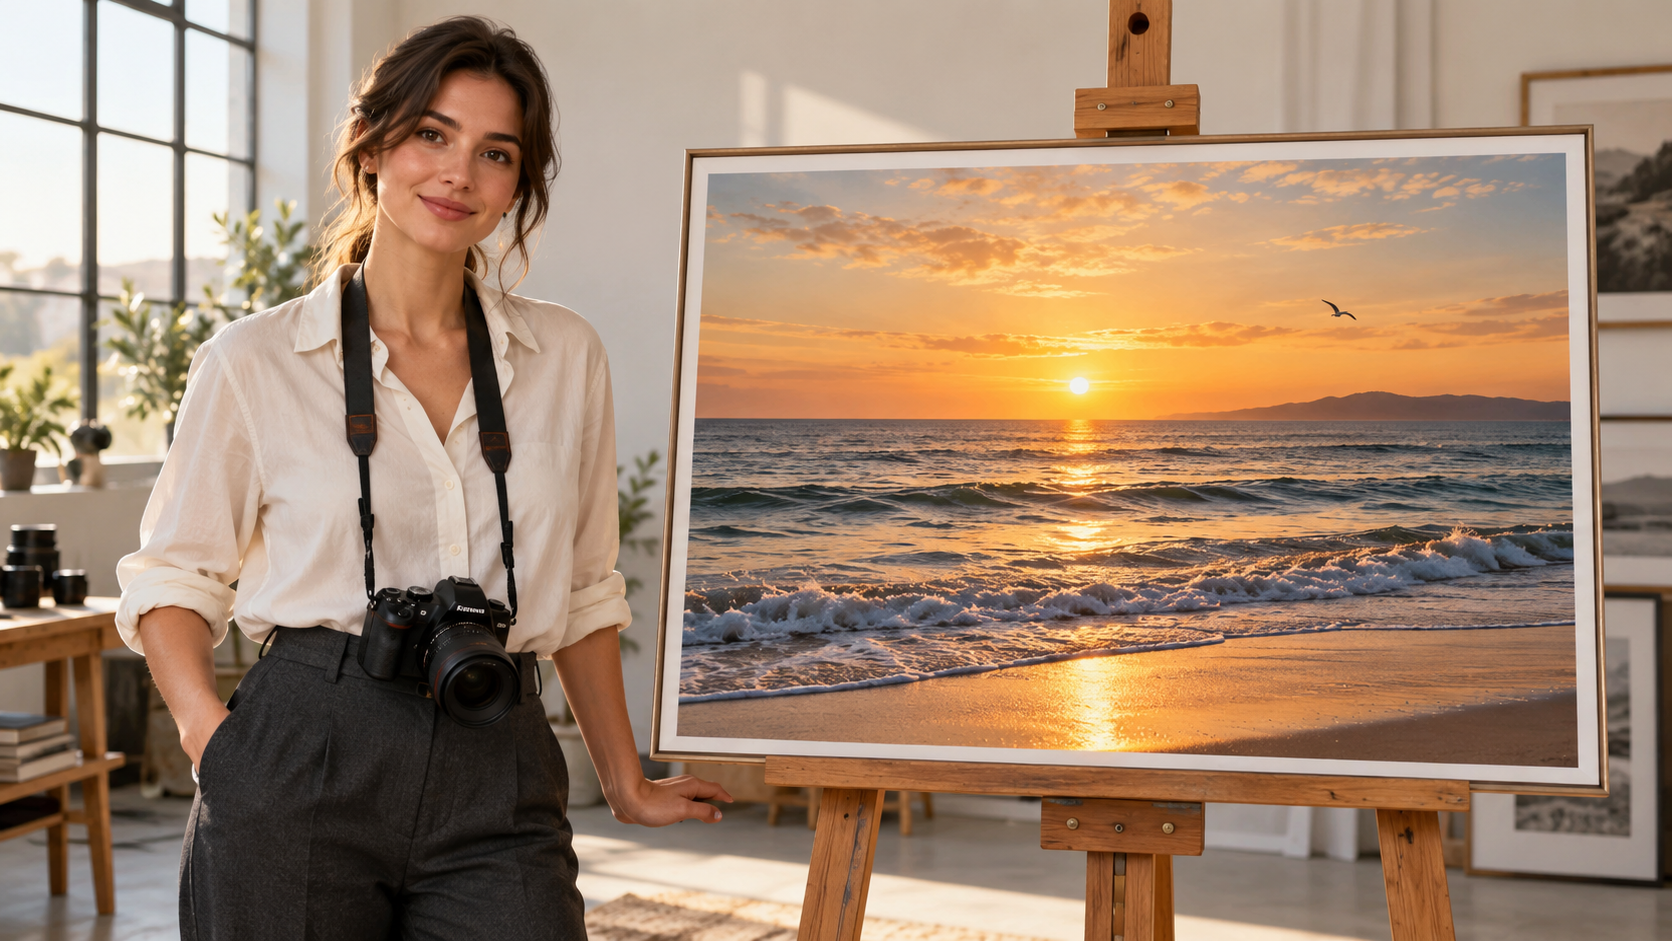
開始フレーム:フォトグラファーと額縁の海景
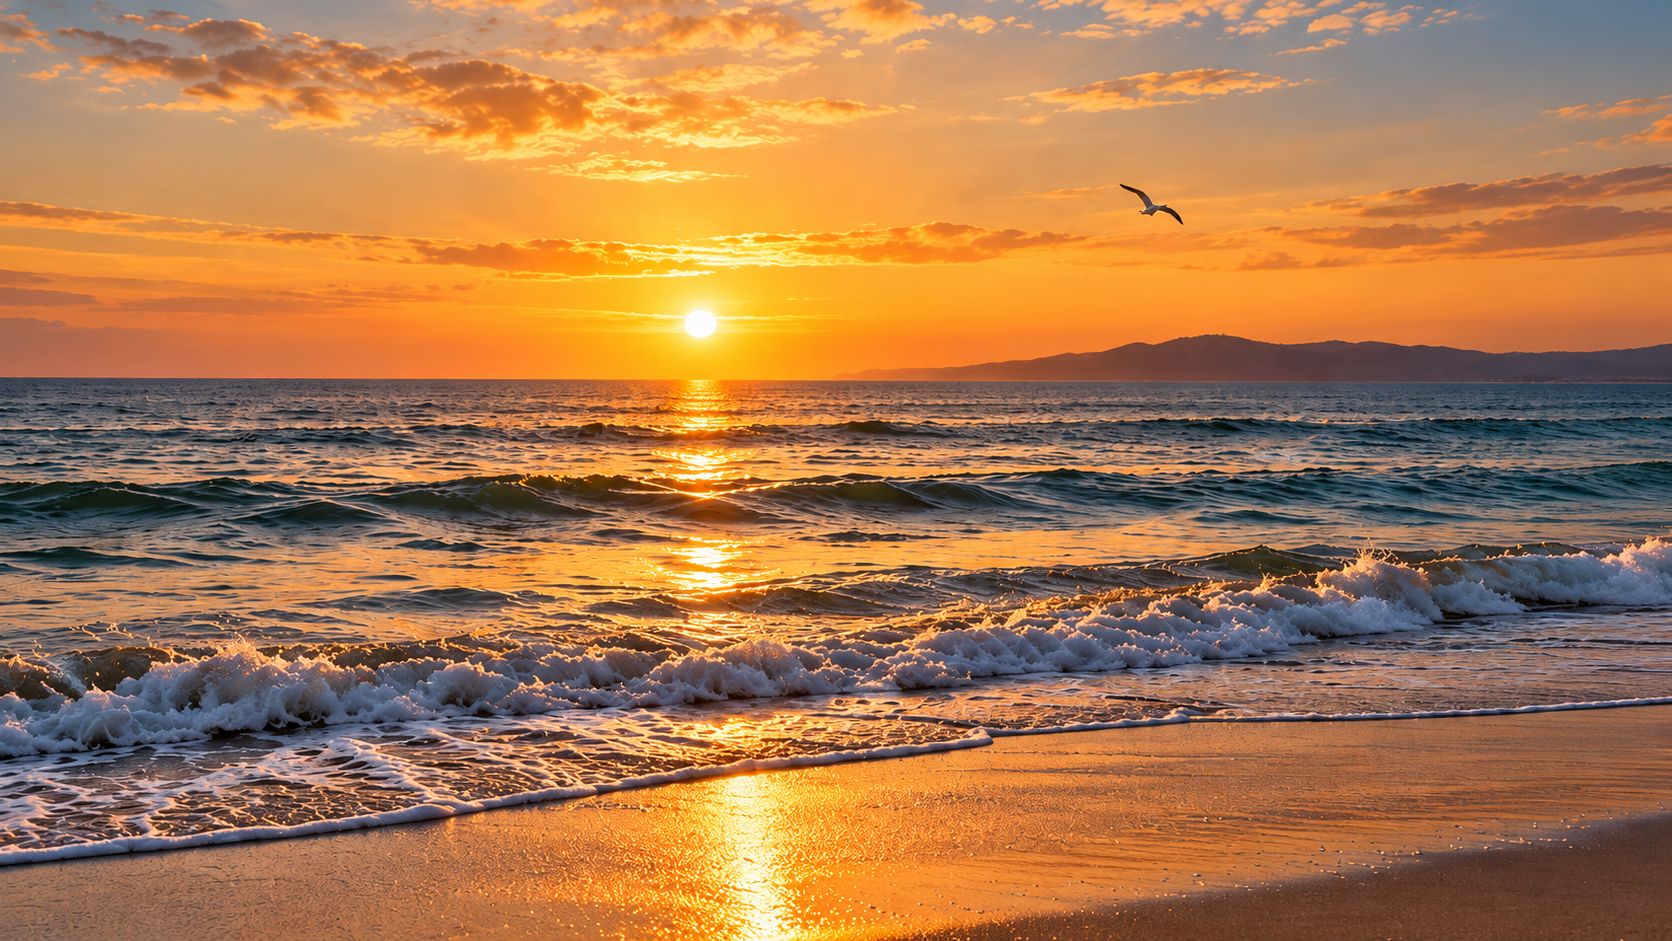
終了フレーム:夕暮れの海岸
Original generation prompt
Photorealistic cinematic style, set in a modern photography studio. A young adult female photographer stands beside an easel displaying a photograph of a beach at sunset. She looks at the photograph, then turns toward the camera and smiles. She speaks in English:
“Let’s bring this photo to life! I made this on Kinovi using the grok-imagine-video-1.5 image-to-video model.”
As she gently gestures toward the photograph, the camera slowly pushes in. The waves within the photograph begin to roll naturally, sunlight shimmers across the water, and a seagull flies through the scene. The photograph’s frame gradually moves out of view until the moving seaside scene fills the entire screen. Natural gestures, accurate lip synchronization with the English dialogue, soft lighting, and a seamless transition. Clear voice audio accompanied by gentle ocean sounds. No added subtitles.
出力が示すもの
約6秒の出力では、フォトグラファーが微笑み、口を動かし、写真に向かってジェスチャーします。カメラがフレームに近づくあいだに波が変化し、最後にはスタジオと額縁が画面外へ去り、海岸が画面を埋めます。提供された2つの構図のあいだの遷移が結果に見えます。
このクリップはフレーム間のビジュアル連続性を示します。プロンプトは英語の台詞も求めていますが、口の動きだけでは文全体が発話されたか、単語単位で同期したかまでは確定できません。これほど短い尺では、台詞の完了は別途確認すべきです。
このアプローチが合う場面
写真のアニメーション、トラベル映像、描かれた世界への遷移に有用です。2フレーム間の意図したつながりを定義し、カメラ移動と発話の両方に十分な時間を残してください。
3. Standard reference-to-video:腕時計・台座・室内を組み合わせる
参照から動画は、別々の商品・ディスプレイ・ロケーション資産をひとつのシーンにまとめられます。この腕時計コンセプトは各画像に役割を割り当て、文字盤のクローズアップ、ケース周りの視点、広い締めのショットを要求します。
Mode: Standard reference-to-video
Input: この順でアップロード:IMAGE_0 腕時計、IMAGE_1 大理石の台座、IMAGE_2 室内。プロンプトのラベルも同じ順序を指します。
File: 約8秒 · 752 × 416 · 24 fps · オーディオトラックあり
Example video
Input images
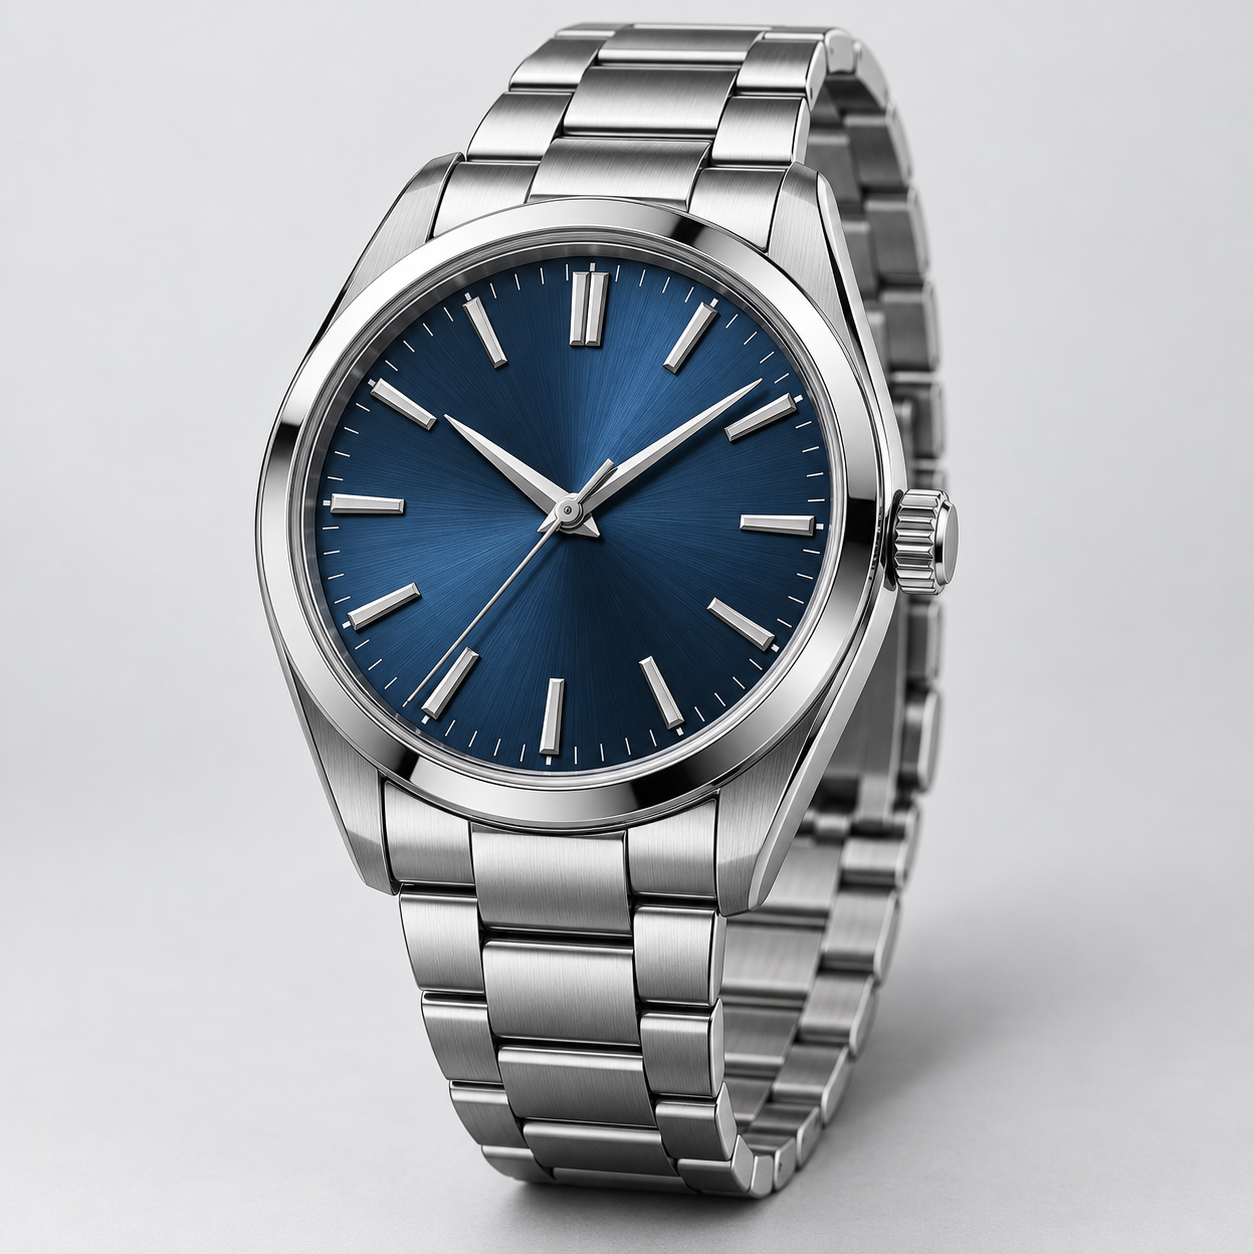
IMAGE_0:シルバーケースとブルー文字盤
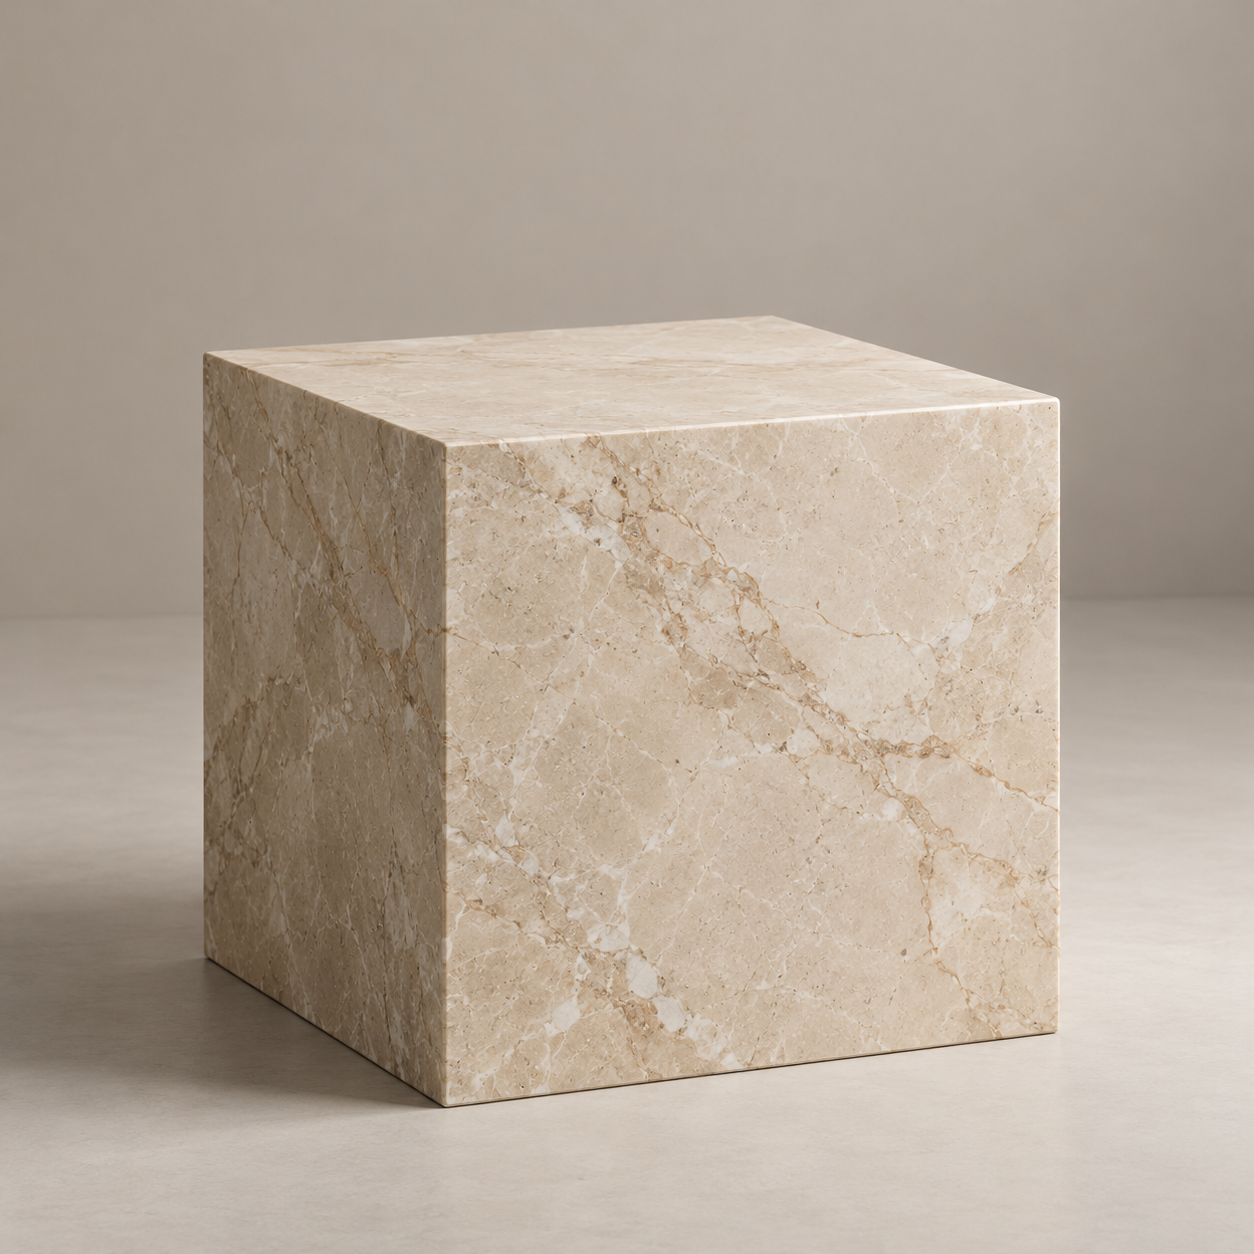
IMAGE_1:ベージュの大理石台座
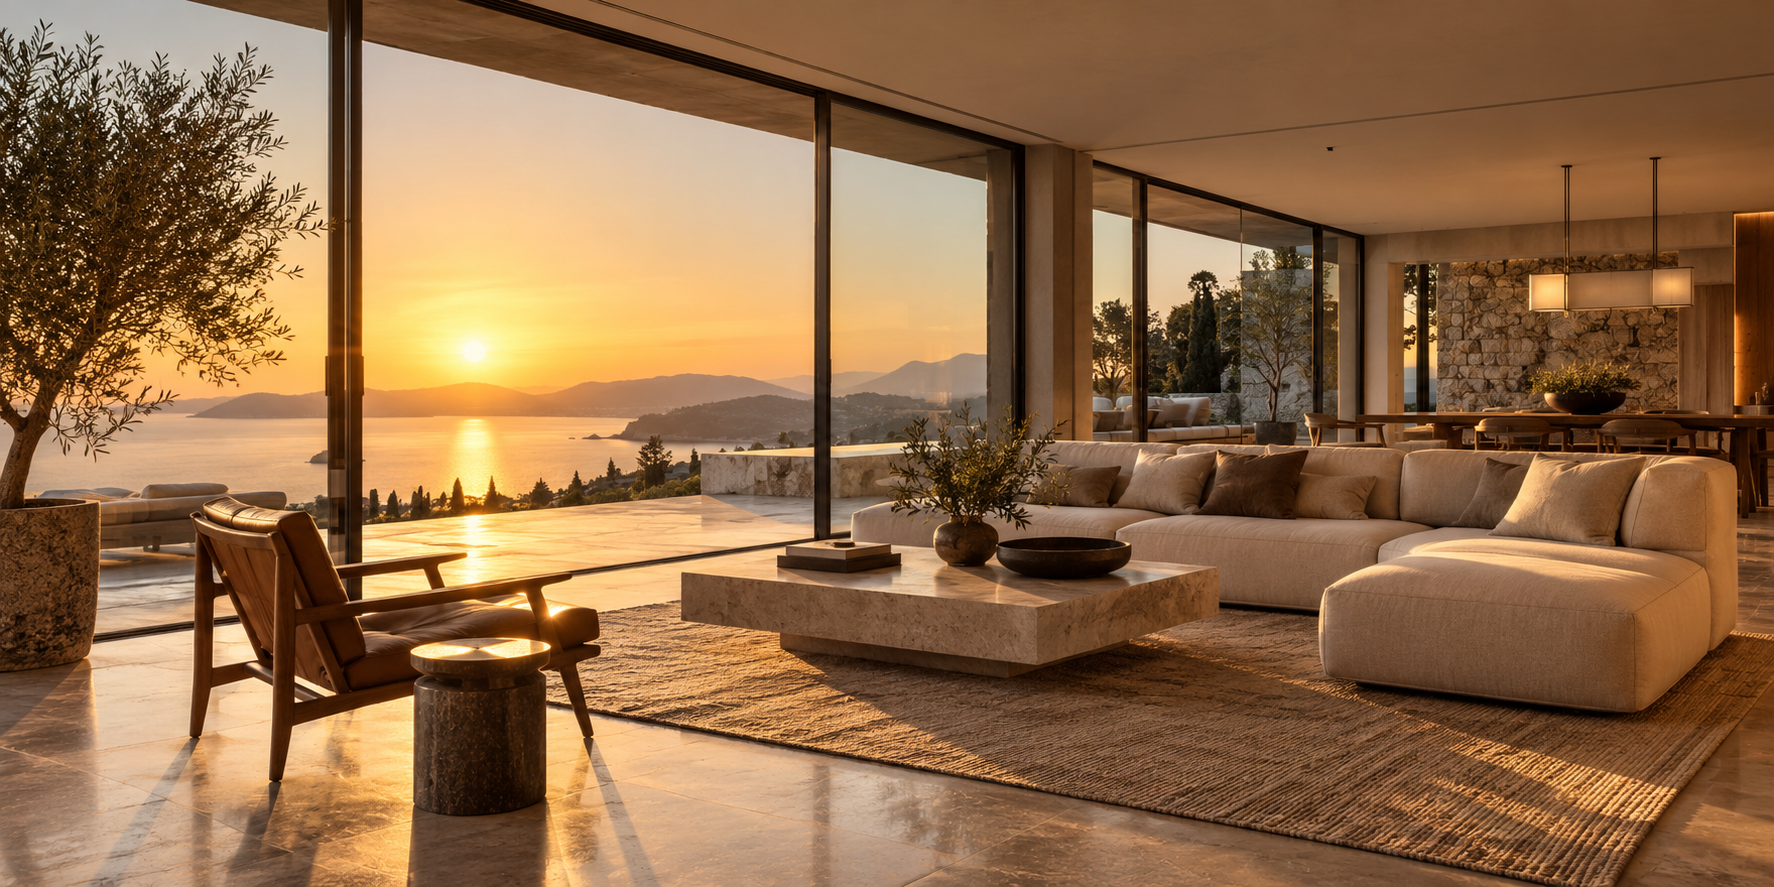
IMAGE_2:ゴールデンアワーの室内
Original generation prompt
Create an 8-second luxury watch commercial by combining three reference images.

<IMAGE_0> is the exact watch product reference. Preserve its silver metal case, blue dial, hands, hour markers, crown placement and bracelet design.
<IMAGE_1> defines the beige marble pedestal and its surface texture.
<IMAGE_2> defines the warm golden-hour interior environment and lighting.

Place the exact watch from <IMAGE_0> upright on the marble pedestal from <IMAGE_1>, inside the setting from <IMAGE_2>.

0–2s: Extreme close-up of the watch dial. Fine metallic reflections reveal the watch's craftsmanship.

2–5s: The camera performs a slow cinematic orbit around the watch, revealing the case thickness, crown and metallic bracelet without altering their original geometry.

5–8s: The camera pulls back to reveal the watch resting on the marble pedestal, with warm sunlight and realistic shadows across the surface.

Maintain exact watch identity and material details throughout. Physically accurate metal reflections, consistent dial markings, realistic contact shadows and correct perspective.

Audio: Subtle mechanical ticking, luxurious ambient music and a gentle final musical accent.

No added logos, no invented text, no product redesign. 16:9.
出力が示すもの
出力はブルー文字盤の近くから始まり、リューズ・ケース・ブレスレットを見せたあと、大理石の表面に立つ腕時計へ引きます。商品・ディスプレイ・温かい室内という3つの主要要素はすべて表現されています。
ただし、商品は完全な複製ではありません。提供された腕時計には日付窓がありませんが、生成されたクローズアップには日付窓/マグニファイアの特徴が現れます。例はマルチ画像の構成とCMショット設計を示しますが、完璧な商品忠実性を保証するものではありません。商品広告に使う前に、文字盤の詳細、マーカー、リューズ位置、ブレスレット構造を別途確認してください。
このアプローチが合う場面
商品ステージングの提案や広告コンセプトに有用です。各参照に明示的な役割を割り当て、クリップを忠実な商品デモとみなす前に、生成された商品詳細を点検してください。
4. Lite text-to-video:午前2時、月を洗う
宇宙飛行士、コインランドリー、月がひとつの設定を共有します。キャラクターはほぼ静止し、カメラ・ドラム・水がそのまわりで動き、ひとつのシュールな焦点を作ります。
Mode: Lite text-to-video
Input: テキストのみ;参照画像なし。
File: 約8秒 · 848 × 480 · 24 fps · オーディオトラックあり
Example video
Original generation prompt
An 8-second cinematic shot inside a quiet, slightly worn neighborhood laundromat at 2 a.m. Rain streaks the storefront windows. A single astronaut sits motionless on a plastic chair, holding an empty laundry basket.

Inside the oversized circular window of the central washing machine, a luminous three-dimensional moon slowly rotates like a heavy object in a wash cycle. Its craters remain clearly visible. A thin ring of water slides around the bottom of the drum, catching silver moonlight.

The camera makes one slow, deliberate push toward the machine. Its warm interior glow gently illuminates the astronaut's visor and the scratched tile floor, contrasting with the cool fluorescent ceiling lights.

Treat this impossible scene with understated photographic realism: restrained colors, tactile surfaces, subtle film grain, controlled highlights. The moon stays inside the drum throughout. One continuous shot, no cuts.

Audio: a low mechanical hum, water softly sloshing, distant rain. No dialogue or music.
出力が示すもの
宇宙飛行士がバスケットを持って座るなか、カメラが近づきます。明るい月は大きなドラム内に留まり、温かい光が濡れた床に反射します。構図は、月の洗い終わりを待つというアイデアをはっきり伝えます。
出力はまた、ドラムから水がこぼれ床に溜まる様子を加え、プロンプトの「機内の細い水の輪」を超えています。月面の変化だけでは、物理的に一貫した三次元回転を検証するには不十分です。ビジュアルのアイデアを確立しつつ、モデルが細部を脚色しうることも示します。
このアプローチが合う場面
予算を意識したビジュアル発想、雰囲気のあるショット、ソーシャル向けクリップを探る方向性です。このシーンは標準のテキストから動画の例とは異なるため、品質の厳密な比較にはなりません。
5. Lite image-to-video:ファッションポートレートに生気を与える
選ばれた開始参照は、出力のアイボリースーツとテラスの設定と一致します。人物・衣装・椅子・壁・薄手のカーテンはすでに定義されているため、動画は小さな表情の動き、髪、生地に焦点を当てます。
Mode: Lite image-to-video
Input: 開始画像1枚:テラスでアイボリースーツを着て座る女性。
File: 約15秒 · 736 × 400 · 24 fps · オーディオトラックあり
Example video
Input images
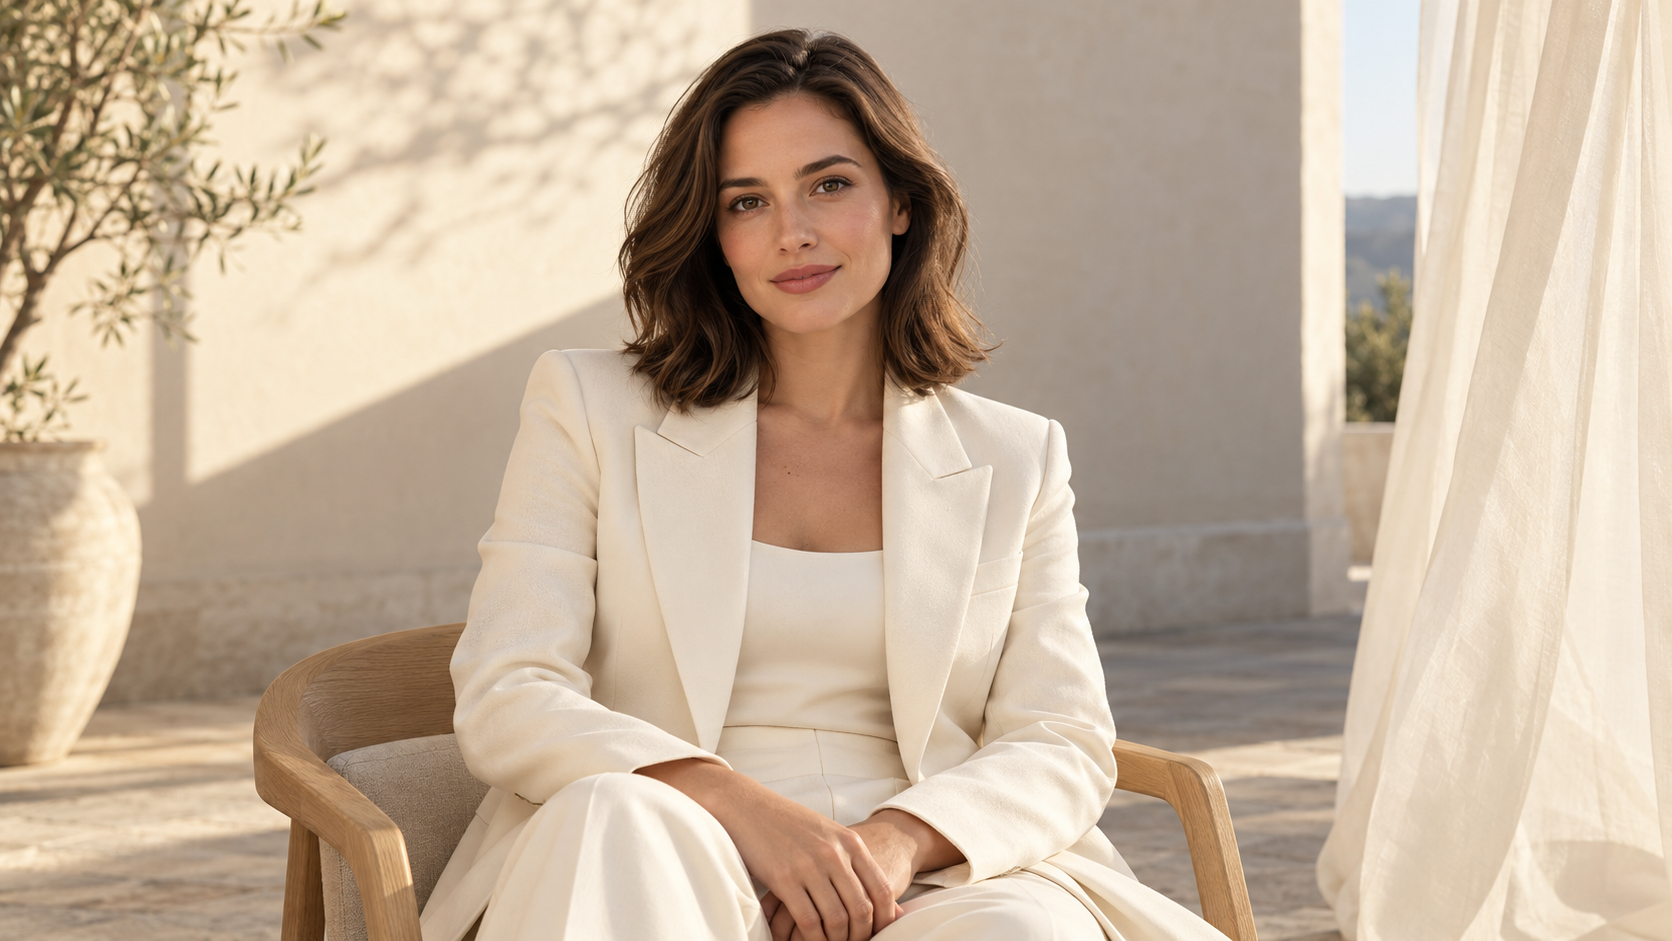
開始フレーム:アイボリースーツのテラスポートレート
Original generation prompt
Use the uploaded portrait as the first frame of a 15-second, 16:9 premium fashion talking-portrait film. Preserve the adult woman’s identity, hairstyle, ivory suit, seated pose, chair, architectural terrace, warm-white wall, sheer curtain, and original composition. Use a locked, eye-level medium shot. Do not change her outfit, location, or identity.

From 0 to 2 seconds, begin naturally from the input image. A gentle breeze moves a few strands of hair beside her ear and the translucent ivory curtain at the side of the frame. Keep the curtain near the image edge, never over her face. She blinks softly, with subtle, natural breathing through her shoulders.

From 2 to 12.5 seconds, she looks into the lens and speaks in composed, confident English: “A portrait can have a cinematic sense of life. I made this with Grok one point five Lite image-to-video on Kinovi.” Her delivery feels like a model sharing a creative moment after a shoot, not a loud sales pitch. Use clear diction and natural pauses. The visible woman speaks the entire line with accurate lip sync. Keep her hands relaxed and use only small eye and head movements; no waving.

From 12.5 to 15 seconds, after the dialogue, she briefly looks toward the sunlight at the side and returns to the camera with a faint smile. The hair and curtain continue moving gently. Hold the camera still and end on the complete fashion-portrait composition.

Champagne-colored side light, soft geometric shadows, realistic skin and suit fabric, and layered, restrained warm whites. No excessive beauty filtering, plastic skin, or strong lens flares. Clear speech, gentle wind, and a very quiet original sparse-piano bed beneath the voice. No off-screen narration, subtitles, magazine cover text, logos, or added on-screen lettering. Maintain stable facial features and clothing. No large head turns or curtain passing through the body.
出力が示すもの
約15秒のクリップは、座った被写体を中心に保ちます。サンプリングしたフレームでは、アイボリースーツ、椅子、温かみのある白い設定が認識できます。口と表情が変わり、カーテンが動き、終わりはより静かな表情に戻ります。
クリップは既存ポートレートの繊細なアニメーションを示します。認識可能な衣装と周囲があっても、フレーム完全なアイデンティティ保持を保証するものではありません。台詞の完了、発音、視聴覚同期も、別途再生確認が必要です。
このアプローチが合う場面
自己紹介、ファッションポートレートのアニメーション、控えめなトーキングヘッドに有用なセットアップです。明確な開始画像と小さな動きのセットが、意図した結果を定義しやすくします。
4. Kinoviで作成を始める
- 入力モードを選ぶ。 アイデアにはテキストから動画、既存の構図には画像から動画、複数のビジュアル資産には参照から動画を使います。
- 素材を用意する。 開始画像ははっきりさせ、終了画像は意図的に。参照ではアップロード順を一貫させ、プロンプトで各画像に役割を割り当てます。
- 尺と出力品質を設定する。 発話とカメラ移動の両方に時間を残します。解像度、オーディオ、対応するフレーミング設定、現在の価格を確認します。
- プロジェクトで重要な点を確認する。 人物なら顔・手・口の動き、商品なら形状・文字・素材、遷移なら始まり・終わり・中間の動きをチェックします。
生成オプションを開く
- Standard text-to-video
- Standard image-to-video
- Standard reference-to-video
- Lite text-to-video
- Lite image-to-video
5. まとめ:先にワークフローを選び、その後でバージョンを評価する
5本の動画は、それぞれ異なる種類の素材から始まります。花屋はテキストからシーンを構築し、スタジオのクリップは2つの構図をつなぎ、腕時計CMは参照を組み合わせ、月のコインランドリーはLiteの低めの掲載レートでシュールなコンセプトを探り、ファッションポートレートは既存の人物と設定を伸ばします。
タスクから始めてください。複数の参照や終了フレームが必要なら、対応する標準オプションを確認してください。テキストベースのアイデアや単一画像のアニメーションなら、試行にLiteも含めてください。 そのうえで、同じタスクの出力を比較し、ディテール・画質・コストがニーズを満たすかを判断します。
説得力のあるムードが、すべての指示に従ったことを意味するわけではなく、魅力的なCMが正確な商品を保証するわけでもありません。有用なワークフローは、創作的な生成と、公開前の丁寧なレビューの両方の余地を残します。
6. よくある質問
1. これら5つは完全に別々のモデルですか?
より実用的な見方は、標準とLiteという2つのバージョンに、異なる入力モードが付く、という整理です。Kinoviはタスク別に選べるよう、別々のオプションとして掲載しています。
2. 画像から動画と参照から動画はどう違いますか?
画像から動画は特定の構図から始まり、標準オプションは終了フレームも取れます。参照から動画は、最初の参照を自動的に固定の開始フレームとはせず、被写体・商品・環境を定義するために画像を使います。一方は構図を伸ばし、他方はビジュアルソースを組み合わせます。
3. 動画に台詞と環境音を含められますか?
5つのオプションすべてがオーディオ生成を公開しています。プロンプトで台詞・環境音・効果・音楽を求められますが、発話の完了・発音・同期は出力で確認してください。長い台詞には十分な尺が必要です。
4. すべてのモードが1080pと開始/終了フレームに対応していますか?
いいえ。標準とLiteのテキストから動画および画像から動画は1080pを掲載していますが、参照から動画は最大720pです。標準の画像から動画は、終了フレーム使用時は720pに制限されます。Liteの画像から動画は開始画像1枚を受け付け、その1080p出力はアップスケールです。
5. Liteは標準より速いですか?品質は同等ですか?
これらの例には比較可能な生成時間の記録やマッチしたタスクがないため、速度や品質の同等性は確立しません。本記事は、LiteをxAI発表のFastバージョンと同一視もしません。
6. コストはどう見積もりますか?
選択したオプションと解像度の現行の1秒あたりレートに、出力尺を掛けます。適用される再試行・失敗・プロモーション条件を確認してください。サンプル動画ファイルだけでは、その生成に請求された金額は確定しません。
7. 参照は商品が変わらないことを保証しますか?
この例はその保証を支えません。腕時計の出力は、参照にない日付窓/マグニファイアの特徴を追加しています。商品マーケティングでは、結果を承認する前に文字盤・文字・形状・構造詳細を点検してください。
8. プロンプトのタイミング指示は秒単位で守られますか?
時間範囲はペースを伝えますが、精密な編集タイムラインではありません。実際の生成設定が利用可能な尺を決め、モデルが背景を早めに見せたり効果を脚色したりすることがあります。必須の台詞とアクションを優先してください。
ソースと検証メモ
プラットフォームの仕様と料金は 2026年10月21日 に確認しました。モデル割り当て、プロンプト、入力画像は提供されたケース素材に従い、出力の尺と寸法はファイルから読み取りました。本記事のために、元動画の編集・吹き替え・字幕付与は行っていません。例はワークフローを示すものであり、全体的なモデル順位を確立するものではありません。
関連記事
More to try
関連モデル
ByteDance · video model
Seedance 2.0
ByteDance による次世代 AI 動画モデル。Fast モードと Pro モードを組み合わせ、高品質な動画生成を実現します。
$0.0707/s
Alibaba · video model
HappyHorse 1.0
HappyHorse 1.0 は、Kinovi で利用できる Alibaba の高品質動画生成モデルです。テキストから動画、画像から動画、参照画像を使った動画生成、動画編集モードに対応しています。
$0.0801/s
ByteDance · video model
Seedance 2.5 API
Seedance 2.5 は、最長30秒の生成、マルチモーダル参照、精密なローカル編集に対応する ByteDance の次世代 AI 動画モデルです。
$0.1197/s