2026 Grok Imagine Video 1.5 auf Kinovi: Fünf Optionen – von kreativen Filmen bis zu Produktwerbung
Fünf echte Video-Beispiele mit Original-Prompts und Referenzbildern sowie Spezifikationen, Preise und FAQs zu Grok Imagine Video 1.5 und Lite auf Kinovi.
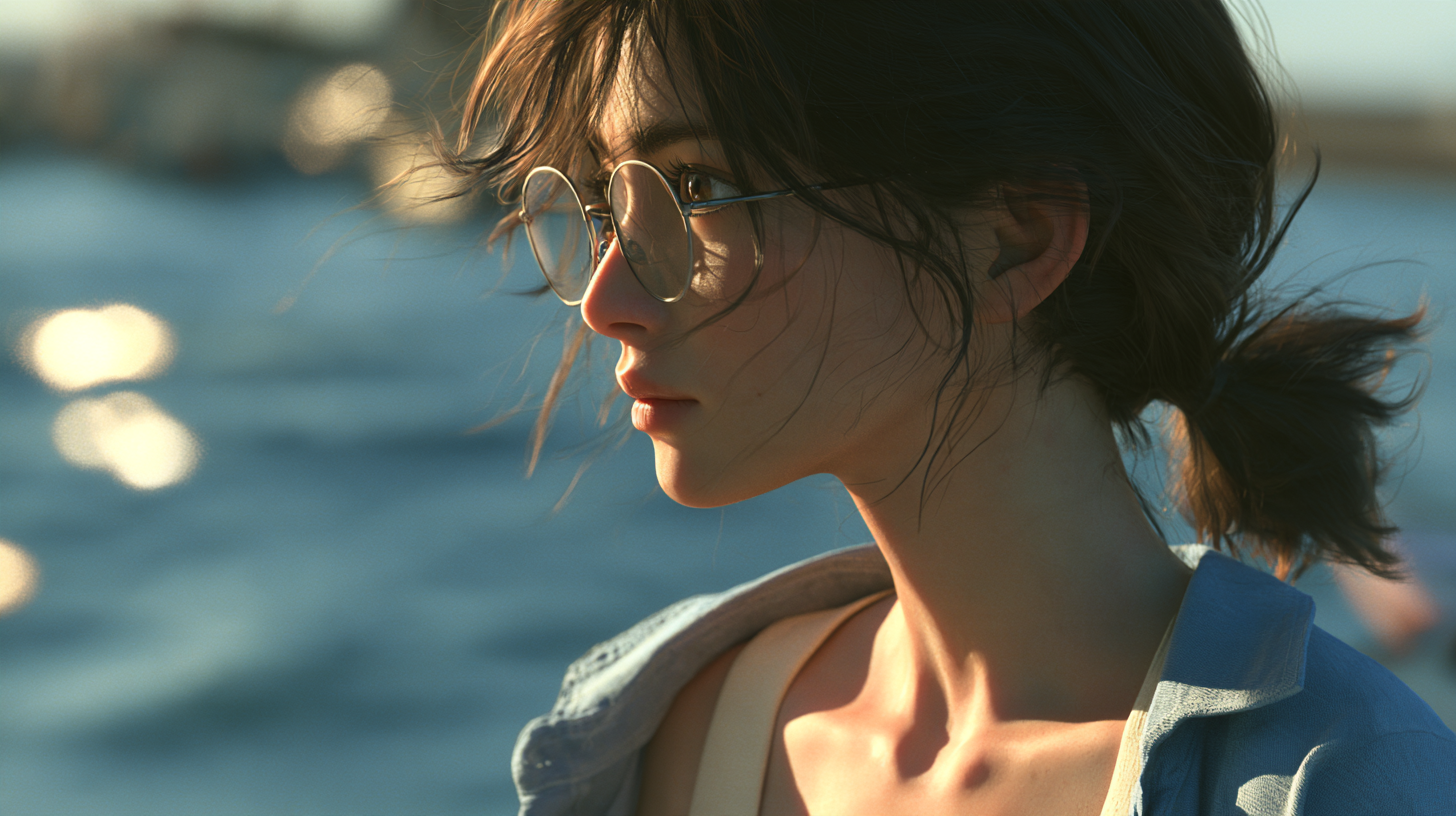
Auf einen Blick: Ein Blumengeschäft über den Wolken, ein Foto, das zum bewegten Strand wird, und ein Uhren-Spot aus drei visuellen Referenzen: Die Familie Grok Imagine Video 1.5 ist auf Kinovi über fünf Standard- und Lite-Optionen verfügbar. Dieser Leitfaden versammelt fünf vorhandene Videos, ihre Eingabebilder, vollständige Prompts, Spezifikationen und aktuelle Preise, damit Sie einen Ausgangspunkt für Ihr eigenes Projekt wählen können.
Ein KI-Videoprojekt beginnt oft mit dem Material, das Sie bereits haben. Eine geschriebene Idee braucht eine Welt darum herum. Ein Foto braucht Bewegung. Getrennte Produkt-, Präsentations- und Standortbilder müssen zu einer einzigen Einstellung werden.
Die folgenden Beispiele folgen dieser Reihenfolge: Standard Text-to-Video, Standard Image-to-Video, Standard Reference-to-Video, Lite Text-to-Video und Lite Image-to-Video. Jedes illustriert eine andere kreative Aufgabe. Ihre Szenen, Dauern und Eingaben unterscheiden sich – daher ist dies eine Showcase und keine kontrollierte Rangfolge von Standard gegenüber Lite.
1. Was bringt Grok Imagine Video 1.5 in den Workflow?
Die Launch-Ankündigung von xAI betont Verbesserungen bei Bewegung, Physik und Audio – einschließlich kohärenterer Bewegung sowie Soundeffekten, Ambiente und Dialog, die besser zur Aktion passen. Das sind Beschreibungen des Anbieters; die folgenden Beispiele zeigen, was in konkreten kreativen Aufgaben passiert ist. Offizielle Ankündigung.
Auf Kinovi umfassen die fünf Optionen drei Eingabemodi und zwei Versionen:
- Text-to-Video: Bauen Sie eine Szene aus einer schriftlichen Beschreibung – ob Konzeptaufnahme, Story-Einstieg oder Werbeidee.
- Image-to-Video: Beginnen Sie mit einem vorhandenen Bild. Die Standard-Option akzeptiert auch ein Endbild; Lite nutzt ein einzelnes Startbild.
- Reference-to-Video: Nutzen Sie mehrere Bilder, um Figur, Produkt oder Umgebung festzulegen und zugleich eine neue Einstellung zu komponieren. Dieser Modus wird auf Kinovi derzeit über die Standard-Option angeboten.
Die Wahl zwischen Standard und Lite betrifft sowohl Preis als auch Funktionen. Lite hat niedrigere gelistete Tarife. Anforderungen wie mehrere visuelle Referenzen oder ein Endbild sollten die Wahl des Eingabemodus leiten – noch vor dem Versionsnamen.
2. Spezifikationen und aktuelle Preise
Die folgenden Angaben wurden am 21. Oktober 2026 mit den Modellseiten von Kinovi abgeglichen. Jede Option verlinkt auf ihre Detailseite.
| Option | Eingabe | Dauer | Ausgabeauflösungen | Wesentlicher Unterschied |
|---|---|---|---|---|
| Standard text-to-video | Text | 1–15 Sekunden | 480p / 720p / 1080p | Szenen aus Text bauen |
| Standard image-to-video | Startbild; optionales Endbild | 1–15 Sekunden | 480p / 720p / 1080p | Bis 720p mit Endbild |
| Standard reference-to-video | 1–7 Referenzbilder und Text | 1–15 Sekunden | 480p / 720p | Visuelle Referenzen kombinieren |
| Lite text-to-video | Text | 1–15 Sekunden | 480p / 720p / 1080p | Niedrigere gelistete Tarife |
| Lite image-to-video | Ein Startbild; optionaler Text | 1–15 Sekunden | 480p / 720p / 1080p | Ein einzelnes Bild animieren |
Alle fünf Optionen unterstützen eine Audiospur und veröffentlichen ein Prompt-Limit von 4.000 Zeichen. Text-to-Video und Reference-to-Video unterstützen mehrere Seitenverhältnisse. Die Einzelbild-Animation folgt dem Eingabebild und dem Framing-Verhalten der Option; der Seitenverhältnis-Parameter von Standard Image-to-Video wird nur verwendet, wenn ein Endbild bereitgestellt wird.
Dieselbe Ausgabeauflösungs-Bezeichnung impliziert nicht denselben Rendering-Prozess. Die aktuelle Dokumentation von xAI beschreibt Standard Text-to-Video und Image-to-Video als native 1080p-fähig, während Lite 1080p durch Upscaling von 720p erreicht. Offizielle Video-Dokumentation.
Tarife pro Sekunde generiertes Video
Alle Beträge unten sind USD pro Ausgabevideo-Sekunde, nicht pro Sekunde Wartezeit auf ein Ergebnis.
| Option | 480p | 720p | 1080p |
|---|---|---|---|
| Standard text-to-video | $0.0501 | $0.0878 | $0.1567 |
| Standard image-to-video | $0.0501 | $0.0878 | $0.1567 |
| Standard reference-to-video | $0.0501 | $0.0878 | Not supported |
| Lite text-to-video | $0.0125 | $0.0188 | $0.0878 |
| Lite image-to-video | $0.0125 | $0.0188 | $0.0878 |
Zum Beispiel kostet bei den aktuellen 720p-Tarifen ein achtsekündiger Standard-Clip 8 × $0.0878 = $0.7024; ein achtsekündiger Lite-Clip 8 × $0.0188 = $0.1504. Das sind illustrative Berechnungen, nicht die tatsächlichen Rechnungen der unten stehenden Clips. Das Preisverhältnis ändert sich je nach Auflösung – daher sollte kein einzelnes Sparverhältnis auf alle Stufen angewendet werden.
Die Seiten für Standard Text-to-Video und Image-to-Video kennzeichnen ihre Tarife als Preview test pricing. Prüfen Sie den beim Absenden angezeigten Betrag sowie die geltenden Fehler-/Erstattungsbedingungen für die gewählte Option.
Grok Imagine Video 1.5: Preise über Plattformen hinweg
Dieser Vergleich deckt nur Standard Grok Imagine Video 1.5 ab und schließt Lite sowie ältere Modelle aus. Geprüft am 21. Oktober 2026. Die Auflösungsspalten zeigen USD pro Ausgabevideo-Sekunde anhand öffentlicher nutzungsbasierter Tarife ohne Mitgliedschaftsumrechnungen, Bonus-Credits oder Abonnementrabatte. Preisquellen stehen unter der Tabelle.
| Plattform | 480p | 720p | 1080p | Zusätzliche Eingabebild-Gebühr | Preisscope |
|---|---|---|---|---|---|
| Kinovi | $0.0501 | $0.0878 | $0.1567 (text/image) | Auf der Seite nicht aufgeschlüsselt; beim Absenden prüfen | Text und Image; Reference-to-Video bis 720p |
| Kie | ≈ $0.012 | ≈ $0.0225 | Public rate unverified | Auf der Seite nicht aufgeschlüsselt; beim Absenden prüfen | 1.5-Preview-Tarife auf der Image-to-Video-Seite veröffentlicht |
| Higgsfield | $0.08 | $0.14 | $0.25 | Separater Aufpreis nicht verifiziert | 1.5-API-Modellfamilien-Tarife; siehe Modus-Hinweise unten |
| fal | $0.08 | $0.14 | $0.25 (text/image) | $0.01 per input image | Text und Image; Reference-to-Video bis 720p |
| Segmind | $0.108 | $0.189 | $0.3375 (text/image) | $0.0135 per input image | Text und Image; Reference-to-Video bis 720p |
| WaveSpeed | $0.08 | $0.14 | $0.25 (text/image) | Single-image mode: $0.01/request; reference mode: $0.01/image | Text und Image; Reference-to-Video bis 720p |
| xAI official | $0.08 | $0.14 | $0.25 (text/image) | $0.01 per input image | Text und Image; Reference-to-Video bis 720p |
Preisquellen: Kinovi · RunningHub · Kie · Higgsfield · fal · Segmind · WaveSpeed · xAI official
Bedingungen, die den Vergleich beeinflussen:
- Kinovi: Standard Text-to-Video und Image-to-Video nutzen das gelistete Preview test pricing. Tarife für den Referenzmodus sind auch auf der Kinovi-Reference-to-Video-Seite verfügbar. Eine Bildgebühr, die nicht aufgeschlüsselt ist, sollte nicht als null angenommen werden.
- RunningHub: Der Katalog listet $0.08/s für die offiziellen Stable-Routen
xai/grok-imagine-video-v1.5/.../stable, ohne auflösungsspezifische Tarife. Dieser Betrag kann nicht auf jede Stufe angewendet werden. Separate Economy-Routenxai/grok-imagine-v1.5/...zeigen $0.03/s; deren Auflösungspreise und entsprechenden Fähigkeiten bleiben unverifiziert und werden daher separat vermerkt statt als Stufenpreise eingetragen. - Kie: Die Seite identifiziert
grok-imagine-video-1-5-previewund listet 2.4 und 4.5 credits/s für 480p und 720p. Die Tabelle verwendet die ungefähren Dollar-Äquivalente der Seite ohne Bonus-Credits. Obwohl 1080p als Option erscheint, wurde der Preis nicht verifiziert; Tarife anderer Modelle werden nicht substituiert. Prüfen Sie die Preview-Kennzeichnung und die Servicebedingungen jeder Plattform separat. - Higgsfield: Das sind öffentliche API-Modellfamilien-Tarife, keine Creator-Abonnement-Umrechnungen. Die Seite illustriert Preise mit einsekündigen Clips bei 480p/720p und 15-sekündigen Clips bei 1080p. Das begründet keine identischen Bedingungen für jede Dauer, jeden Referenzmodus oder jede zusätzliche Eingabe.
- Modi und Zusatzkosten: Auflösungsgrenzen und Bildgebühren im Referenzmodus sind auf den Seiten fal reference-to-video, Segmind reference-to-video und WaveSpeed reference-to-video dokumentiert. Die Segmind-Text-to-Video-Preisseite hat widersprüchliche Beträge in Tabelle und Erklärungstext; dieser Vergleich nutzt die explizite Preistabelle. Bestätigen Sie den Betrag vor dem Absenden.
Um eine Gesamtsumme zu schätzen, addieren Sie ausgewiesene Eingabegebühren zur Video-Generierungsgebühr. Zum Beispiel beträgt der offizielle xAI-Preis für einen achtsekündigen 720p-Clip mit einem Eingabebild 8 × $0.14 + $0.01 = $1.13. Rein textbasierte Generierung hat keine Eingabebild-Gebühr. „Unverified“ bedeutet weder „unsupported“ noch „free“. Diese Zahlen sind Budget-Referenzen; Preis und Servicebedingungen beim Absenden haben Vorrang.
3. Fünf Beispiele, in Modellreihenfolge
Jedes Beispiel enthält das gelieferte Video, Eingabebilder falls zutreffend und den originalen englischen Prompt. Dialog und Timing-Anweisungen in einem Prompt beschreiben die beabsichtigte Ausgabe; sie sind kein wörtliches Transkript des generierten Audios. Visuelle Kommentare basieren auf abgetasteten Frames, Dateidetails stammen aus Medienmetadaten. Es wurde keine wortgenaue Sprach- oder Lippensynchronisationsmessung durchgeführt.
| Reihenfolge | Option | Beispiel | Ungefähre Dateidauer | Dateidimensionen |
|---|---|---|---|---|
| 1 | Standard text-to-video | Blumengeschäft über den Wolken | 15 seconds | 848 × 480 |
| 2 | Standard image-to-video | In ein Strandfoto eintreten | 6 seconds | 848 × 480 |
| 3 | Standard reference-to-video | Uhren-Spot | 8 seconds | 752 × 416 |
| 4 | Lite text-to-video | Mond-Waschsalon | 8 seconds | 848 × 480 |
| 5 | Lite image-to-video | Modeporträt | 15 seconds | 736 × 400 |
Das sind die Dimensionen der empfangenen Dateien, nicht die Maximalfähigkeiten der Modelle und kein Nachweis aller ursprünglichen Absende-Einstellungen. Alle fünf Dateien sind 24 fps und enthalten eine Audiospur.
1. Standard text-to-video: ein Blumengeschäft über den Wolken
Es gibt kein Startbild und kein Referenz-Asset. Das Konzept beginnt als Text: eine Hochhaus-Terrasse zur blauen Stunde, ein Blumengeschäft über den Wolken, warme praktische Lichter und eine Floristin, die eine Blume arrangiert. Der Prompt spezifiziert außerdem eine On-Camera-Zeile, eine leuchtende Blume und eine abschließende Kamerabewegung, die die weitere Umgebung enthüllt.
Modus: Standard text-to-video
Eingabe: Nur Text; keine Referenzbilder.
Datei: etwa 15 Sekunden · 848 × 480 · 24 fps · Audiospur vorhanden
Beispielvideo
Originaler Generierungs-Prompt
Create a 15-second, 16:9 cinematic promotional film with photorealistic materials and one continuous shot. A boutique flower shop occupies a high-rise terrace above a sea of clouds at blue hour. Small amber lights illuminate a wooden workbench, plain ceramic vases, and ivory flowers. Soft foreground petals partly conceal the view. Only a hint of the clouds and distant city lights is visible at first; save the wide reveal for the ending.

The florist is an adult East Asian woman around 28, with short dark hair, a smoky-gray linen apron, and a cream shirt. Her manner is calm and confident. From 0 to 2 seconds, the camera slides gently past the foreground petals. She places one ivory flower into a vase. Its center begins to emit a subtle warm glow, no brighter than a small night-light, casting believable light on her fingertips. The flower retains its physical botanical shape; it does not dissolve or become particles.

From 2 to 12.5 seconds, settle into a steady eye-level medium shot with her face and mouth clearly visible. Looking into the lens, she speaks in warm, clear English: “This flower shop above the clouds began as words. I brought it to life with Grok one point five text-to-video on Kinovi.” She briefly glances at the flower, then returns her gaze to the camera. All speech comes directly from the visible woman, with accurate lip sync and natural pauses, not from an off-screen narrator.

From 12.5 to 15 seconds, after the dialogue, slowly pull back to reveal the cloud-filled skyline beyond the terrace. Keep the florist and shop within the composition and settle on a quiet, complete final image.

Soft side lighting, realistic skin, tactile wood and linen, restrained deep-blue and warm-gold color contrast. The glowing flower center is the only close-range magical effect. Clear voice, a delicate stem-against-ceramic sound, faint high-altitude wind, and a very quiet atmospheric music bed beneath the dialogue. No subtitles, titles, readable signs, logos, or added text. Avoid frantic cuts, exaggerated acting, heavy bloom, floating particles, and complicated hand gestures.
Was die Ausgabe zeigt
Die Wolkenlandschaft ist bereits zu Beginn sichtbar. Die Floristin stellt die leuchtende Blume in eine Vase, blickt im Mittelteil in die Kamera und bleibt im Bild, während die Kamera zurückzieht und mehr von Werkbank und Laden freigibt. Kühle blaue Umgebung und die warme Blume schaffen einen klaren visuellen Fokus.
Das Ergebnis folgt nicht jedem Detail wörtlich. Der Prompt spart die weite Wolken-Enthüllung für das Ende auf, doch ein Großteil des Hintergrunds ist von Anfang an sichtbar. Das Leuchten erstreckt sich zudem über die Blütenblätter, statt im Blütenzentrum zu bleiben. Die große kreative Idee kommt durch – mit Abweichungen bei Reveal- und Beleuchtungsanweisungen.
Wo dieser Ansatz passt
Eine nützliche Richtung für Werbekonzepte, imaginierte Orte und Brand-Story-Einstellungen. Wenn Sie einen Prompt in Setting, Aktion, Dialog und finale Komposition gliedern, lässt sich das Ergebnis leichter bewerten.
2. Standard image-to-video: in den Strand innerhalb eines Fotos eintreten
Dieses Beispiel liefert einen klaren Anfang und ein klares Ziel: eine Fotografin neben einer Staffelei im Startbild und ein Sonnenuntergangsstrand im Endbild. Die Aufgabe ist, diese Räume zu verbinden, die Wellen im Foto zu animieren und die Kamera in die Küstenszene zu bewegen.
Modus: Standard image-to-video
Eingabe: Das gelieferte Frame-Paar ist unten gezeigt: das Studio-Porträt als Startframe und die Sonnenuntergangsküste als Endframe.
Datei: etwa 6 Sekunden · 848 × 480 · 24 fps · Audiospur vorhanden
Beispielvideo
Eingabebilder
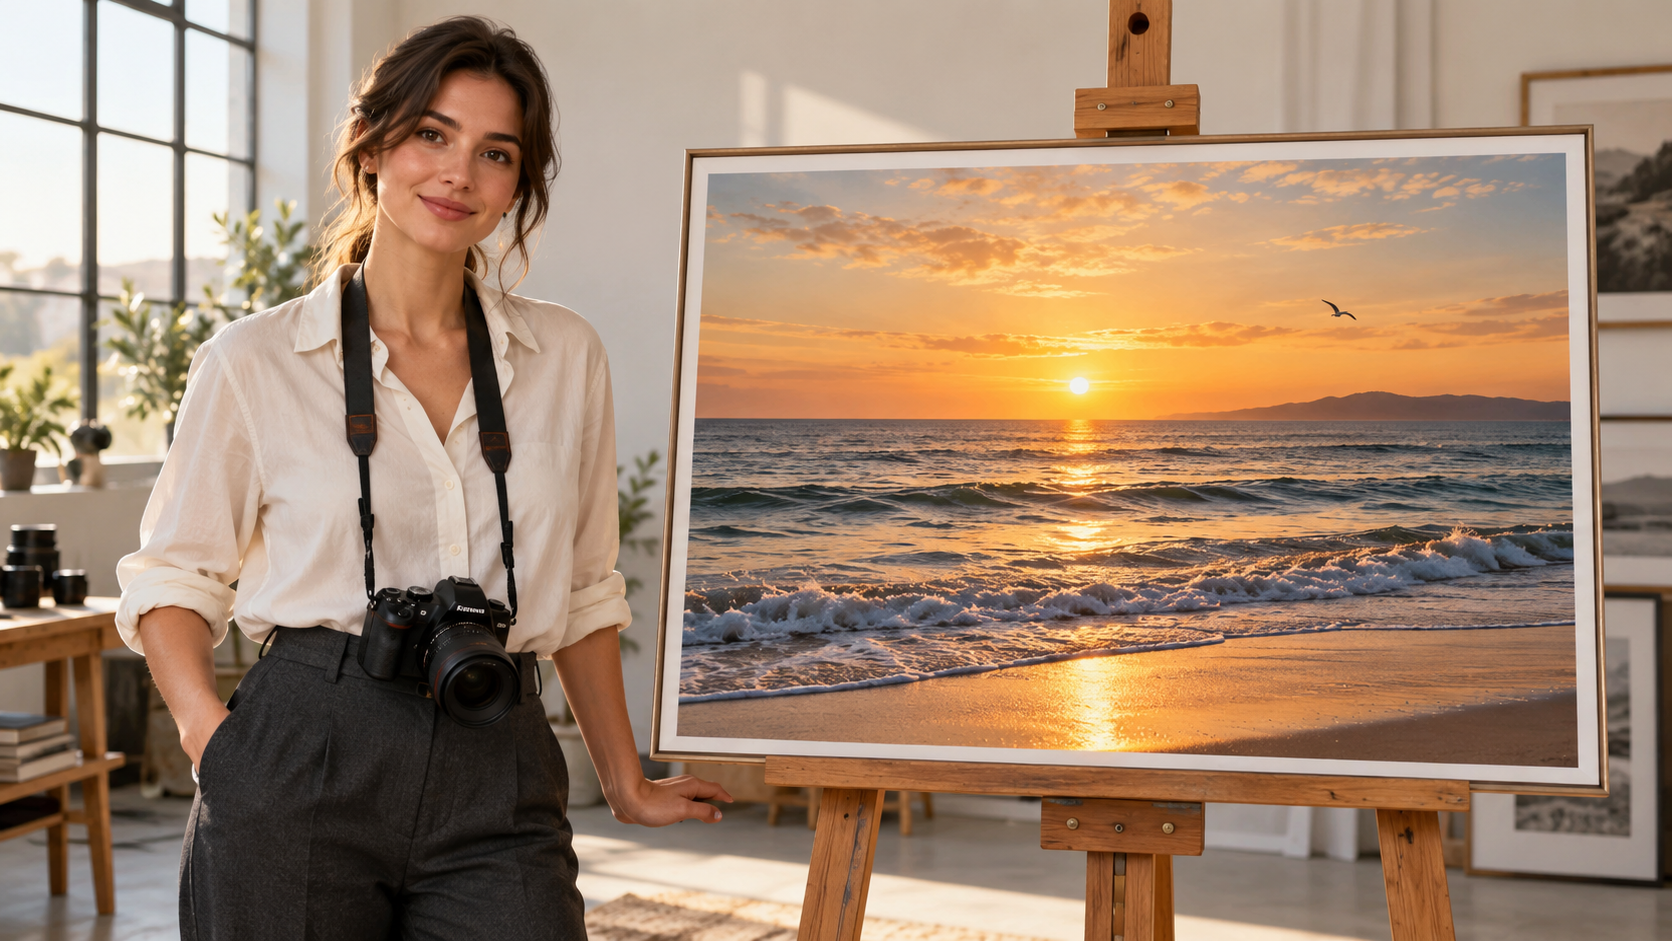
Startframe: Fotografin und gerahmte Seelandschaft
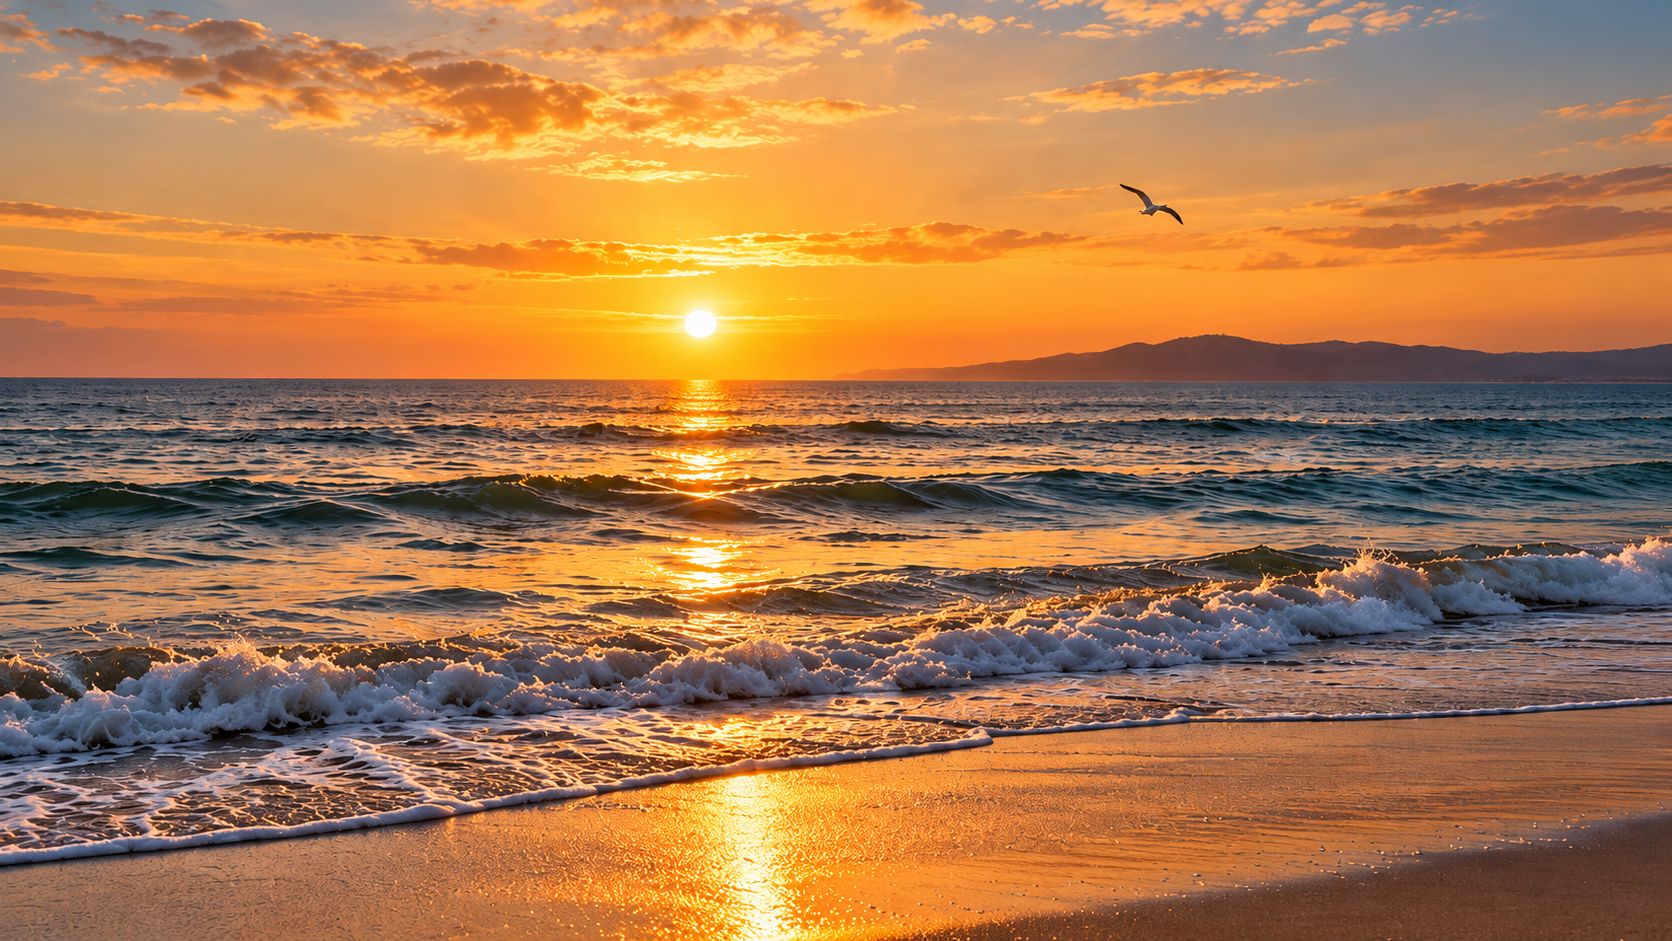
Endframe: Sonnenuntergangsküste
Originaler Generierungs-Prompt
Photorealistic cinematic style, set in a modern photography studio. A young adult female photographer stands beside an easel displaying a photograph of a beach at sunset. She looks at the photograph, then turns toward the camera and smiles. She speaks in English:
“Let’s bring this photo to life! I made this on Kinovi using the grok-imagine-video-1.5 image-to-video model.”
As she gently gestures toward the photograph, the camera slowly pushes in. The waves within the photograph begin to roll naturally, sunlight shimmers across the water, and a seagull flies through the scene. The photograph’s frame gradually moves out of view until the moving seaside scene fills the entire screen. Natural gestures, accurate lip synchronization with the English dialogue, soft lighting, and a seamless transition. Clear voice audio accompanied by gentle ocean sounds. No added subtitles.
Was die Ausgabe zeigt
In der etwa sechssekündigen Ausgabe lächelt die Fotografin, bewegt den Mund und gestikuliert zum Bild. Die Kamera nähert sich dem Rahmen, während sich die Wellen verändern; am Ende haben Studio und Bilderrahmen das Bild verlassen, und die Küste füllt den Bildschirm. Der Übergang zwischen den beiden gelieferten Kompositionen ist im Ergebnis sichtbar.
Dieser Clip illustriert visuelle Kontinuität von Frame zu Frame. Der Prompt verlangt außerdem eine englische Zeile, doch Mundbewegung allein belegt nicht, dass der gesamte Satz gesprochen oder wortgenau synchronisiert wurde. Bei so kurzer Laufzeit sollte die Dialogvollständigkeit separat geprüft werden.
Wo dieser Ansatz passt
Ein nützlicher Ansatz für Fotoanimation, Reisevisuals und Übergänge in eine abgebildete Welt. Definieren Sie die beabsichtigte Verbindung zwischen den beiden Frames und lassen Sie genug Zeit für Kamerabewegung und Sprache.
3. Standard reference-to-video: Uhr, Podest und Raum kombinieren
Reference-to-Video kann getrennte Produkt-, Präsentations- und Standort-Assets in einer Szene zusammenführen. Dieses Uhrenkonzept weist jedem Bild eine Rolle zu und fordert dann eine Zifferblatt-Nahaufnahme, eine Ansicht um das Gehäuse und eine breitere Abschlussaufnahme an.
Modus: Standard reference-to-video
Eingabe: In dieser Reihenfolge hochladen: IMAGE_0 Uhr, IMAGE_1 Marmorpodest, IMAGE_2 Innenraum. Die Prompt-Labels beziehen sich auf dieselbe Reihenfolge.
Datei: etwa 8 Sekunden · 752 × 416 · 24 fps · Audiospur vorhanden
Beispielvideo
Eingabebilder
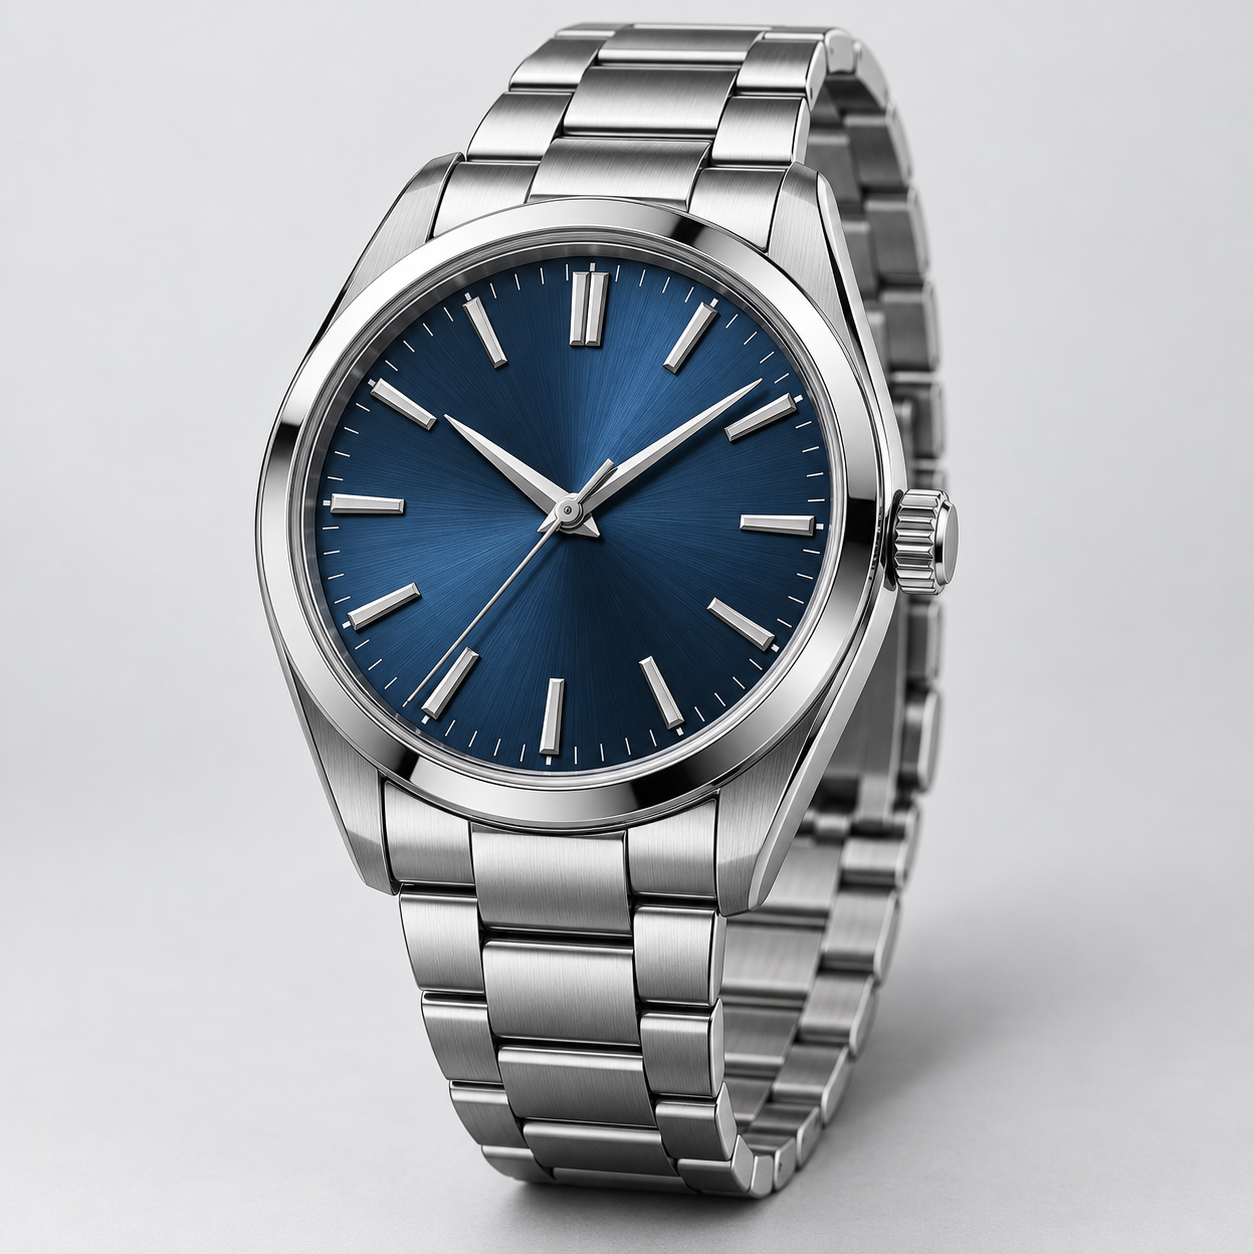
IMAGE_0: silbernes Gehäuse und blaues Zifferblatt
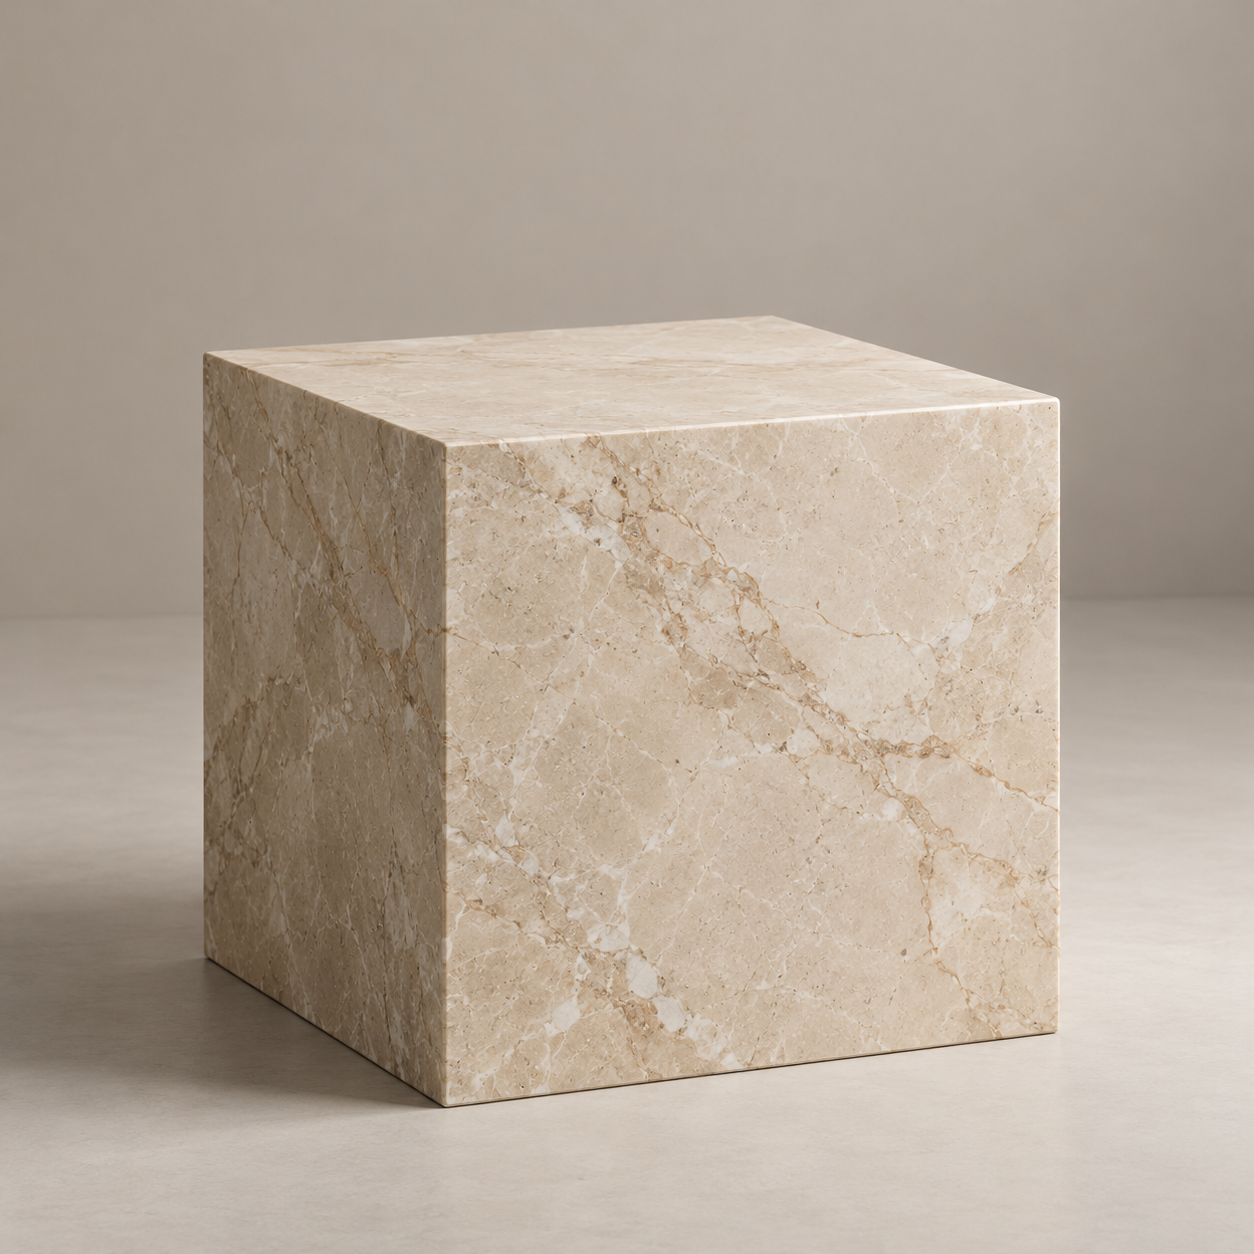
IMAGE_1: beiges Marmorpodest
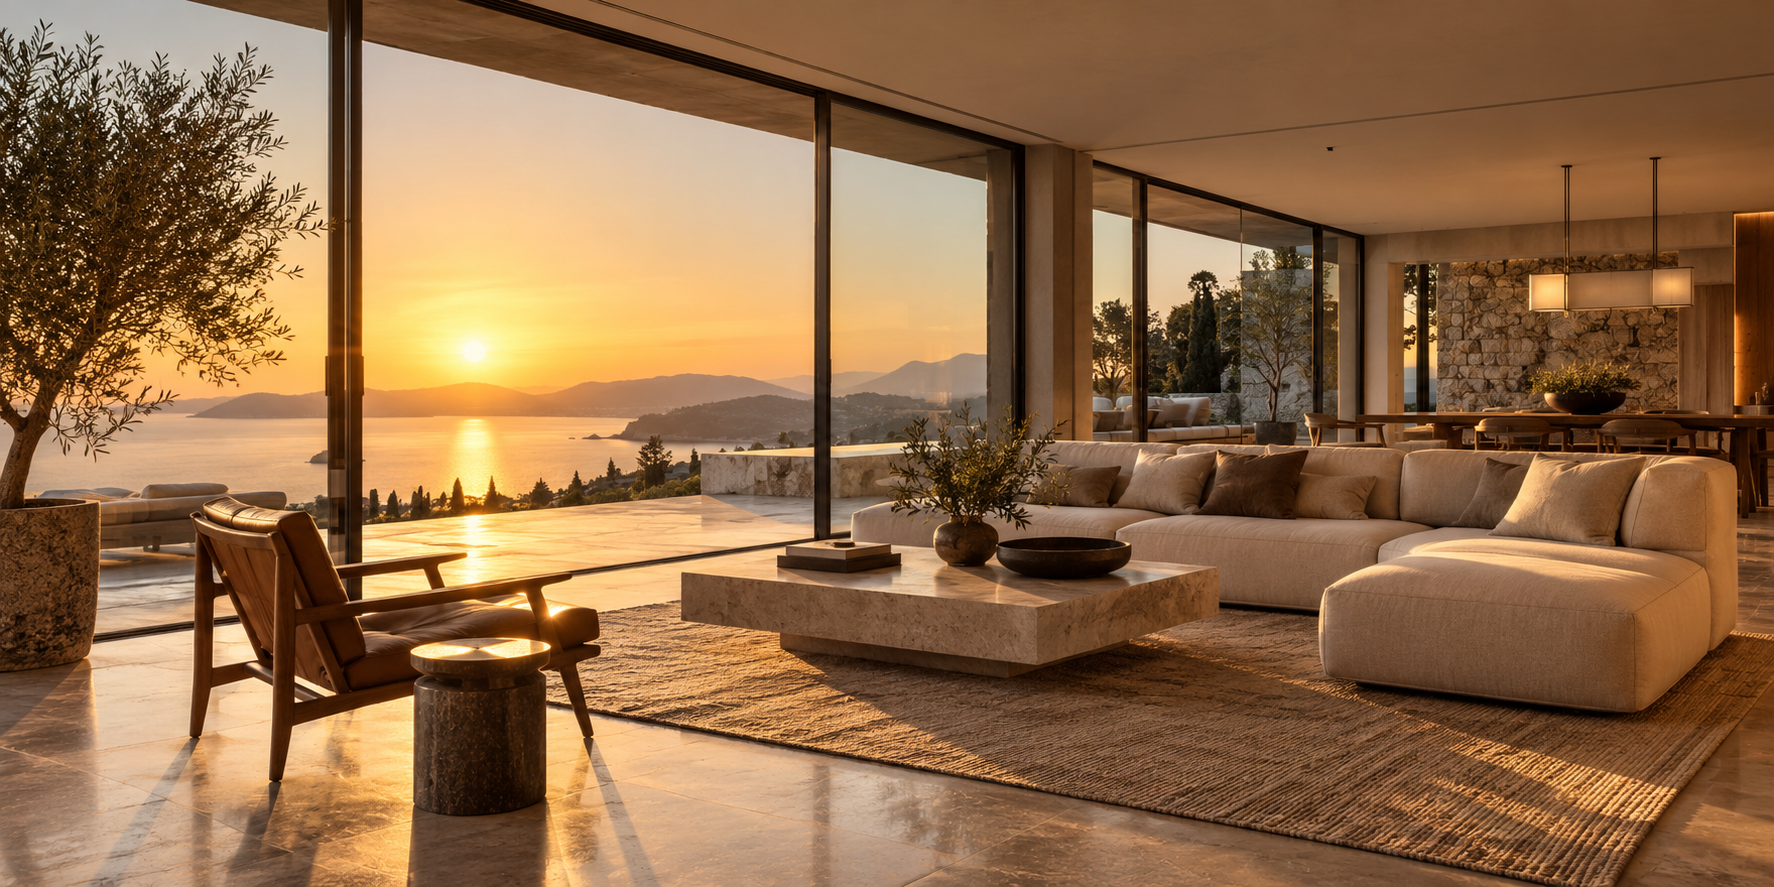
IMAGE_2: Golden-Hour-Innenraum
Originaler Generierungs-Prompt
Create an 8-second luxury watch commercial by combining three reference images.

<IMAGE_0> is the exact watch product reference. Preserve its silver metal case, blue dial, hands, hour markers, crown placement and bracelet design.
<IMAGE_1> defines the beige marble pedestal and its surface texture.
<IMAGE_2> defines the warm golden-hour interior environment and lighting.

Place the exact watch from <IMAGE_0> upright on the marble pedestal from <IMAGE_1>, inside the setting from <IMAGE_2>.

0–2s: Extreme close-up of the watch dial. Fine metallic reflections reveal the watch's craftsmanship.

2–5s: The camera performs a slow cinematic orbit around the watch, revealing the case thickness, crown and metallic bracelet without altering their original geometry.

5–8s: The camera pulls back to reveal the watch resting on the marble pedestal, with warm sunlight and realistic shadows across the surface.

Maintain exact watch identity and material details throughout. Physically accurate metal reflections, consistent dial markings, realistic contact shadows and correct perspective.

Audio: Subtle mechanical ticking, luxurious ambient music and a gentle final musical accent.

No added logos, no invented text, no product redesign. 16:9.
Was die Ausgabe zeigt
Die Ausgabe öffnet nah am blauen Zifferblatt, zeigt Krone, Gehäuse und Armband und zieht dann zurück, bis die Uhr auf einer Marmorfläche steht. Alle drei Hauptzutaten – Produkt, Präsentation und warmer Innenraum – sind vertreten.
Das Produkt ist jedoch keine exakte Nachbildung. Die gelieferte Uhr hat kein Datumsfenster, während die generierte Nahaufnahme ein Datumsfenster-/Lupen-Feature einführt. Das Beispiel zeigt Multi-Bild-Komposition und Werbe-Shot-Design; es begründet keine perfekte Produkt-Treue. Zifferblatt-Details, Markierungen, Kronenposition und Armbandstruktur brauchen vor der Nutzung in einer Produktwerbung eine separate Prüfung.
Wo dieser Ansatz passt
Nützlich für Produkt-Staging-Vorschläge und Werbekonzepte. Weisen Sie jeder Referenz explizite Rollen zu und prüfen Sie die generierten Produktdetails, bevor Sie den Clip als treue Produktdemonstration behandeln.
4. Lite text-to-video: einen Mond um 2 Uhr morgens waschen
Ein Astronaut, ein Waschsalon und ein Mond teilen sich ein Setting. Die Figur bleibt nahezu still, während Kamera, Trommel und Wasser Bewegung um einen surrealen Fokuspunkt erzeugen.
Modus: Lite text-to-video
Eingabe: Nur Text; keine Referenzbilder.
Datei: etwa 8 Sekunden · 848 × 480 · 24 fps · Audiospur vorhanden
Beispielvideo
Originaler Generierungs-Prompt
An 8-second cinematic shot inside a quiet, slightly worn neighborhood laundromat at 2 a.m. Rain streaks the storefront windows. A single astronaut sits motionless on a plastic chair, holding an empty laundry basket.

Inside the oversized circular window of the central washing machine, a luminous three-dimensional moon slowly rotates like a heavy object in a wash cycle. Its craters remain clearly visible. A thin ring of water slides around the bottom of the drum, catching silver moonlight.

The camera makes one slow, deliberate push toward the machine. Its warm interior glow gently illuminates the astronaut's visor and the scratched tile floor, contrasting with the cool fluorescent ceiling lights.

Treat this impossible scene with understated photographic realism: restrained colors, tactile surfaces, subtle film grain, controlled highlights. The moon stays inside the drum throughout. One continuous shot, no cuts.

Audio: a low mechanical hum, water softly sloshing, distant rain. No dialogue or music.
Was die Ausgabe zeigt
Die Kamera kommt näher, während der Astronaut mit einem Korb sitzt. Der helle Mond bleibt in der übergroßen Trommel, und sein warmes Licht spiegelt sich auf dem nassen Boden. Die Komposition vermittelt klar die Idee, darauf zu warten, dass ein Mond seinen Waschgang beendet.
Die Ausgabe fügt außerdem Wasser hinzu, das aus der Trommel läuft und sich auf dem Boden sammelt – über den im Prompt genannten dünnen Wasserring in der Maschine hinaus. Veränderungen auf der Mondoberfläche reichen allein nicht aus, um eine physikalisch konsistente dreidimensionale Rotation zu verifizieren. Das Ergebnis etabliert die visuelle Idee und zeigt zugleich, wie das Modell Details ausarbeiten kann.
Wo dieser Ansatz passt
Eine Richtung zum Erkunden für budgetbewusste visuelle Ideation, atmosphärische Einstellungen und Social Clips. Diese Szene unterscheidet sich vom Standard-Text-to-Video-Beispiel und ist daher kein kontrollierter Qualitätsvergleich.
5. Lite image-to-video: einem Modeporträt Leben geben
Die gewählte Startreferenz entspricht dem Elfenbeinanzug und der Terrassenkulisse der Ausgabe. Person, Outfit, Stuhl, Wand und transparenter Vorhang sind bereits definiert – das Video konzentriert sich daher auf kleine Gesichtsbewegungen, Haar und Stoff.
Modus: Lite image-to-video
Eingabe: Ein Startbild: eine sitzende Frau in einem Elfenbeinanzug auf einer Terrasse.
Datei: etwa 15 Sekunden · 736 × 400 · 24 fps · Audiospur vorhanden
Beispielvideo
Eingabebilder
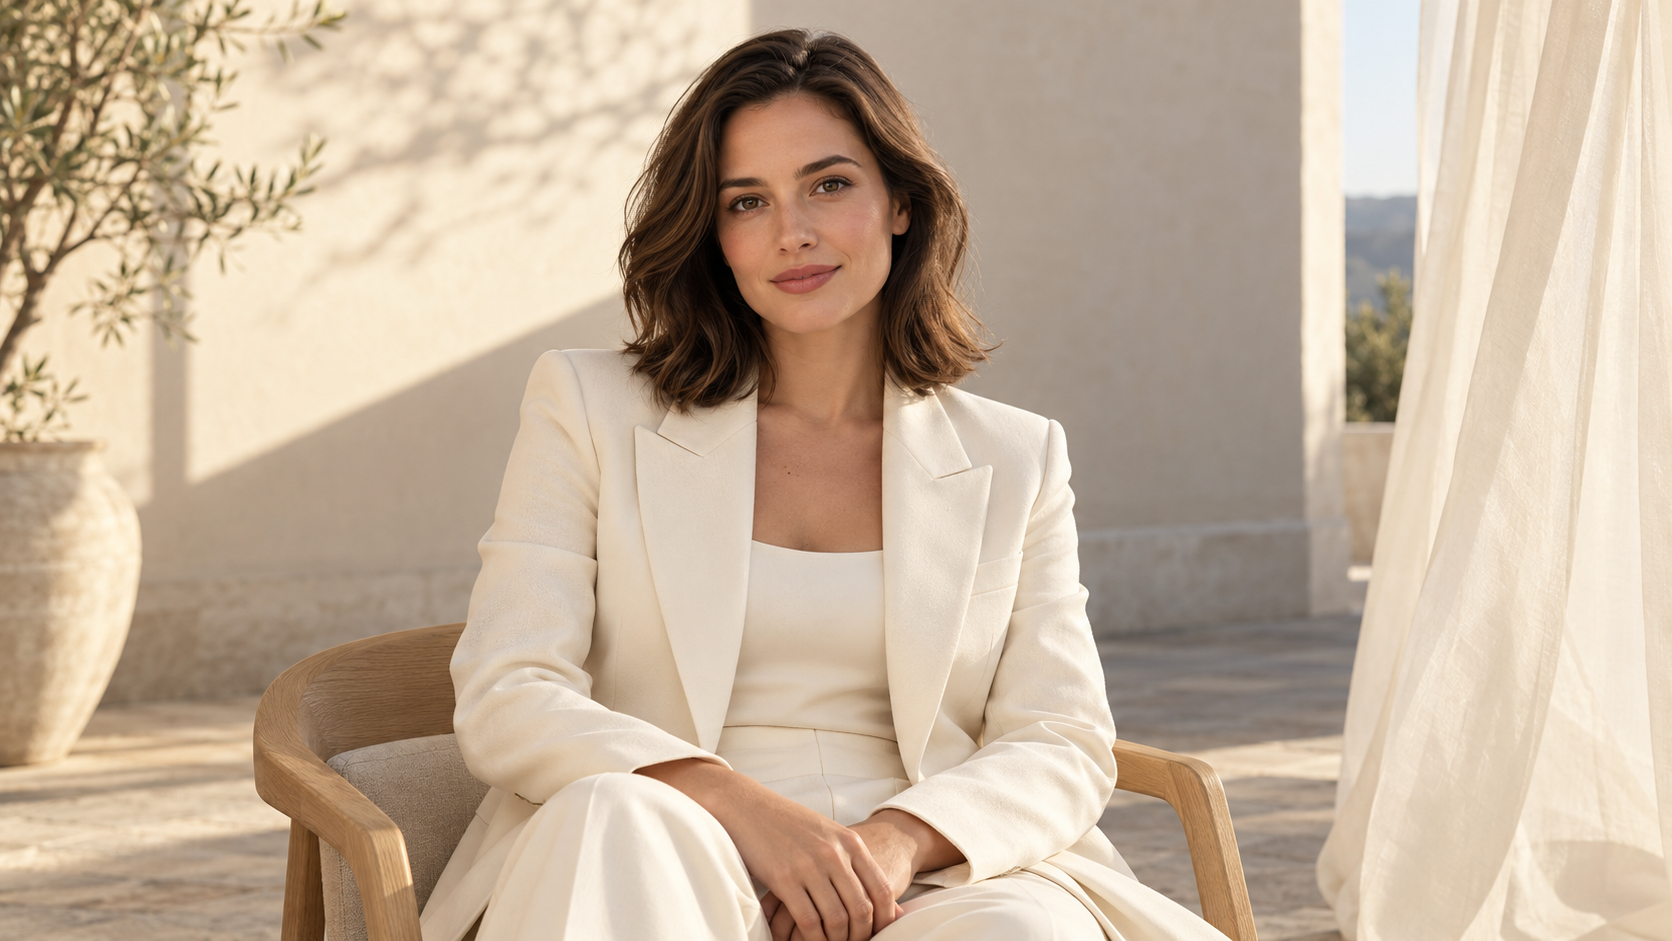
Startframe: Terrassenporträt im Elfenbeinanzug
Originaler Generierungs-Prompt
Use the uploaded portrait as the first frame of a 15-second, 16:9 premium fashion talking-portrait film. Preserve the adult woman’s identity, hairstyle, ivory suit, seated pose, chair, architectural terrace, warm-white wall, sheer curtain, and original composition. Use a locked, eye-level medium shot. Do not change her outfit, location, or identity.

From 0 to 2 seconds, begin naturally from the input image. A gentle breeze moves a few strands of hair beside her ear and the translucent ivory curtain at the side of the frame. Keep the curtain near the image edge, never over her face. She blinks softly, with subtle, natural breathing through her shoulders.

From 2 to 12.5 seconds, she looks into the lens and speaks in composed, confident English: “A portrait can have a cinematic sense of life. I made this with Grok one point five Lite image-to-video on Kinovi.” Her delivery feels like a model sharing a creative moment after a shoot, not a loud sales pitch. Use clear diction and natural pauses. The visible woman speaks the entire line with accurate lip sync. Keep her hands relaxed and use only small eye and head movements; no waving.

From 12.5 to 15 seconds, after the dialogue, she briefly looks toward the sunlight at the side and returns to the camera with a faint smile. The hair and curtain continue moving gently. Hold the camera still and end on the complete fashion-portrait composition.

Champagne-colored side light, soft geometric shadows, realistic skin and suit fabric, and layered, restrained warm whites. No excessive beauty filtering, plastic skin, or strong lens flares. Clear speech, gentle wind, and a very quiet original sparse-piano bed beneath the voice. No off-screen narration, subtitles, magazine cover text, logos, or added on-screen lettering. Maintain stable facial features and clothing. No large head turns or curtain passing through the body.
Was die Ausgabe zeigt
Der etwa 15-sekündige Clip bleibt auf der sitzenden Person zentriert. Elfenbeinanzug, Stuhl und warmweiße Kulisse bleiben in den abgetasteten Frames erkennbar. Mund und Ausdruck ändern sich, der Vorhang bewegt sich, und das Ende kehrt zu einem ruhigeren Ausdruck zurück.
Der Clip illustriert subtile Animation eines vorhandenen Porträts. Erkennbare Kleidung und Umgebung begründen keine framegenaue Identitätserhaltung. Dialogvollständigkeit, Aussprache und audiovisuelle Synchronisation brauchen ebenfalls eine eigene Wiedergabeprüfung.
Wo dieser Ansatz passt
Ein nützliches Setup für persönliche Vorstellungen, Modeporträt-Animation und zurückhaltende Talking-Head-Inhalte. Ein klares Startbild und ein kleines Set an Bewegungen machen das gewünschte Ergebnis leichter definierbar.
4. Auf Kinovi mit dem Erstellen beginnen
- Wählen Sie den Eingabemodus. Nutzen Sie Text-to-Video für eine Idee, Image-to-Video für eine vorhandene Komposition oder Reference-to-Video für mehrere visuelle Assets.
- Bereiten Sie das Material vor. Machen Sie das Startbild klar und das Endbild bewusst. Bei Referenzen halten Sie die Upload-Reihenfolge konsistent und weisen Sie jedem Bild im Prompt eine Rolle zu.
- Legen Sie Dauer und Ausgabequalität fest. Lassen Sie Zeit für Sprache und Kamerabewegung. Prüfen Sie Auflösung, Audio, unterstützte Framing-Einstellungen und den aktuellen Preis.
- Prüfen Sie, was für das Projekt zählt. Bei Personen: Gesichter, Hände und Lippenbewegung; bei Produkten: Geometrie, Beschriftung und Materialien; bei Übergängen: Anfang, Ende und Zwischenbewegung.
Eine Generierungsoption öffnen
- Standard text-to-video
- Standard image-to-video
- Standard reference-to-video
- Lite text-to-video
- Lite image-to-video
5. Fazit: Zuerst den Workflow wählen, dann die Version bewerten
Die fünf Videos starten von unterschiedlichen Materialarten. Das Blumengeschäft baut eine Szene aus Text; der Studio-Clip verbindet zwei Kompositionen; der Uhren-Spot kombiniert Referenzen; der Mond-Waschsalon erkundet ein surreales Konzept zum niedrigeren Lite-Tarif; und das Modeporträt erweitert eine vorhandene Figur und Kulisse.
Beginnen Sie mit der Aufgabe. Bei mehreren Referenzen oder einem Endframe prüfen Sie die entsprechende Standard-Option. Bei textbasierten Ideen oder Einzelbild-Animation nehmen Sie Lite in Ihre Tests auf. Vergleichen Sie anschließend Ausgaben derselben Aufgabe, um zu entscheiden, ob Detail, Bildqualität und Kosten Ihren Anforderungen genügen.
Eine überzeugende Stimmung bedeutet nicht, dass jede Anweisung befolgt wurde, und ein attraktiver Spot garantiert kein präzises Produkt. Ein nützlicher Workflow lässt Raum für kreative Generierung und für eine sorgfältige Prüfung vor der Veröffentlichung.
6. Häufig gestellte Fragen
1. Sind das fünf völlig getrennte Modelle?
Sinnvoller ist es, sie als zwei Versionen – Standard und Lite – mit unterschiedlichen Eingabemodi zu navigieren. Kinovi listet sie als separate Optionen, damit Creator nach Aufgabe wählen können.
2. Worin unterscheiden sich Image-to-Video und Reference-to-Video?
Image-to-Video startet von einer konkreten Komposition; die Standard-Option kann auch ein Endframe nehmen. Reference-to-Video nutzt Bilder, um Motive, Produkte oder Umgebungen zu definieren, ohne die erste Referenz automatisch als festes Öffnungsframe zu behandeln. Das eine erweitert eine Komposition; das andere kombiniert visuelle Quellen.
3. Können die Videos Sprache und Umgebungs-Audio enthalten?
Alle fünf Optionen stellen Audio-Generierung bereit. Prompts können Dialog, Ambiente, Effekte und Musik anfordern, doch Sprachvollständigkeit, Aussprache und Synchronisation sollten in der Ausgabe geprüft werden. Längere Zeilen brauchen genug Laufzeit.
4. Unterstützen alle Modi 1080p sowie Start-/Endframes?
Nein. Standard- und Lite-Text-to-Video sowie Image-to-Video listen 1080p, während Reference-to-Video bei 720p endet. Standard Image-to-Video ist auf 720p begrenzt, wenn ein Endframe verwendet wird. Lite Image-to-Video akzeptiert ein einzelnes Startbild, und die 1080p-Ausgabe ist upscaled.
5. Ist Lite schneller oder qualitativ gleichwertig mit Standard?
Diese Beispiele enthalten weder vergleichbare Generierungszeit-Aufzeichnungen noch gematchte Aufgaben und begründen daher keine Geschwindigkeits- oder Qualitätsparität. Dieser Artikel setzt Lite auch nicht mit der Fast-Version aus der xAI-Ankündigung gleich.
6. Wie schätze ich die Kosten?
Multiplizieren Sie den aktuellen Sekundentarif der gewählten Option und Auflösung mit der Ausgabedauer. Prüfen Sie geltende Retry-, Fehler- und Aktionsbedingungen. Eine Beispielvideodatei allein belegt nicht den für ihre Generierung berechneten Betrag.
7. Garantieren Referenzen ein unverändertes Produkt?
Dieses Beispiel stützt diese Garantie nicht. Die Uhren-Ausgabe fügt ein Datumsfenster-/Lupen-Feature hinzu, das in der Referenz fehlt. Für Produktmarketing prüfen Sie Zifferblatt, Beschriftung, Geometrie und strukturelle Details, bevor Sie das Ergebnis freigeben.
8. Werden Prompt-Timing-Anweisungen sekundengenau befolgt?
Zeitbereiche kommunizieren das Tempo, sind aber keine präzise Schnitt-Timeline. Die tatsächlichen Generierungseinstellungen bestimmen die verfügbare Laufzeit, und das Modell kann einen Hintergrund früh enthüllen oder einen Effekt ausarbeiten. Priorisieren Sie wesentliche Sprache und Aktionen.
Quellen und Verifikationshinweise
Plattform-Spezifikationen und Tarife wurden am 21. Oktober 2026 geprüft. Modellzuordnungen, Prompts und Eingabebilder folgen dem gelieferten Fallmaterial; Ausgabedauern und Dimensionen wurden aus den Dateien gelesen. Die Originalvideos wurden für diesen Artikel nicht bearbeitet, synchronisiert oder untertitelt. Die Beispiele illustrieren Workflows und begründen kein Gesamt-Ranking der Modelle.
Verwandte Artikel
More to try
Verwandte Modelle
ByteDance · video model
Seedance 2.0
KI-Videomodell der nächsten Generation von ByteDance. Kombiniert Fast- und Pro-Modus für hochwertige Videogenerierung.
$0.0707/s
Alibaba · video model
HappyHorse 1.0
HappyHorse 1.0 ist Alibabas hochwertiges Videogenerierungsmodell auf Kinovi und unterstützt die Modi Text-zu-Video, Bild-zu-Video, Referenzbild-Video und Videobearbeitung.
$0.0801/s
OpenAI · image model
GPT Image 2
Fortschrittliche KI-Bildgenerierung und -bearbeitung von OpenAI. GPT Image 2 glänzt bei Fotorealismus, Textdarstellung, komplexen Kompositionen und präziser Umsetzung von Anweisungen.
$0.0100/image