2026 Kinovi의 Grok Imagine Video 1.5: 크리에이티브 영상부터 제품 광고까지, 다섯 가지 선택
원본 프롬프트와 참조 이미지가 포함된 실제 영상 예시 다섯 편과 함께, Kinovi의 Grok Imagine Video 1.5 및 Lite 사양·요금·FAQ를 정리합니다.
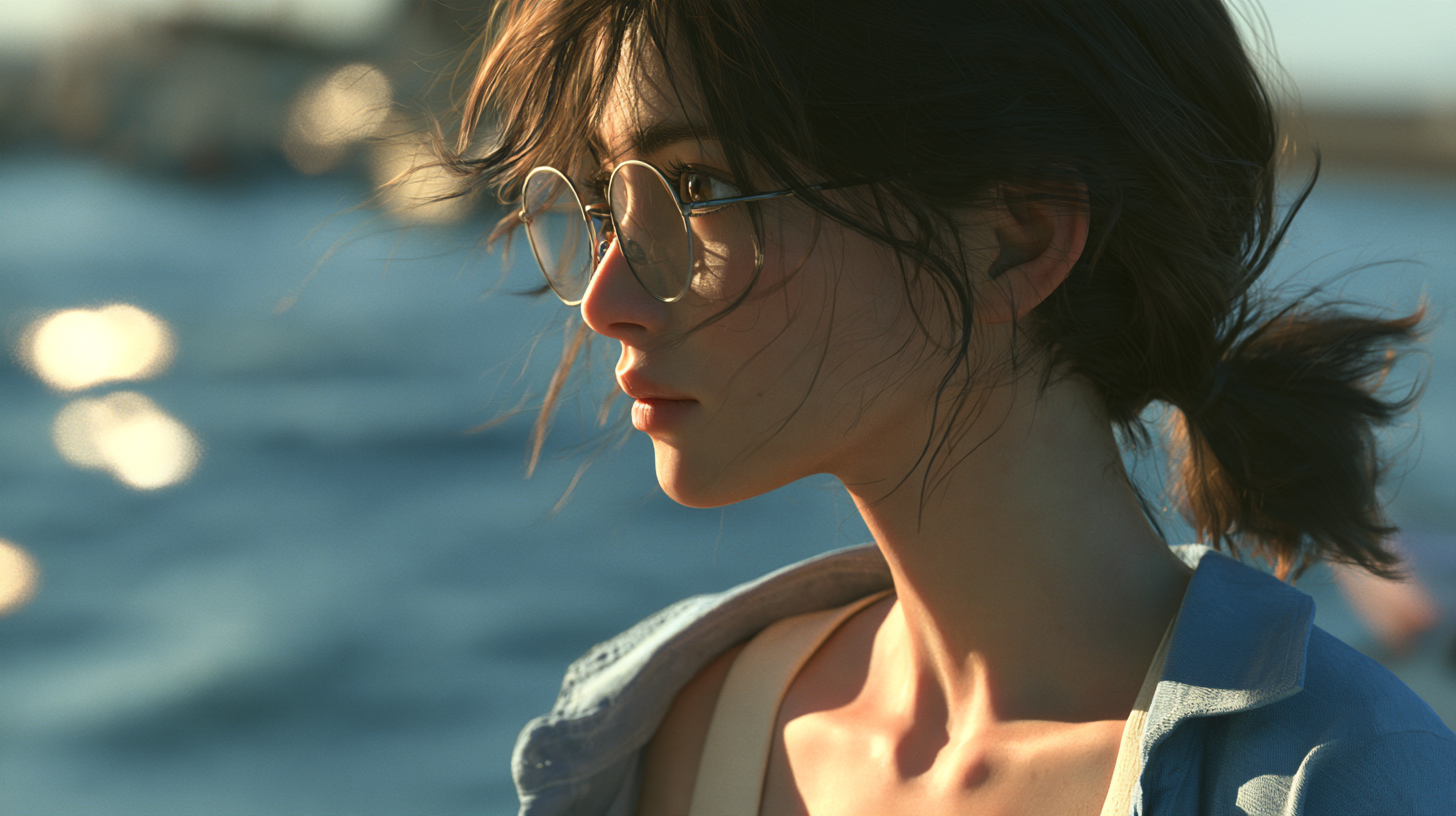
한눈에 보기: 구름 위 꽃집, 사진 속에서 움직이는 해변, 세 장의 비주얼 참조로 조립한 시계 광고. Grok Imagine Video 1.5 패밀리는 Kinovi에서 표준과 Lite를 합쳐 다섯 가지 옵션으로 제공됩니다. 이 가이드는 기존 영상 다섯 편, 입력 이미지, 완전한 프롬프트, 사양, 현재 요금을 모아 여러분의 프로젝트 출발점을 고르는 데 도움을 줍니다.
AI 영상 프로젝트는 이미 갖고 있는 소재에서 시작하는 경우가 많습니다. 글로 된 아이디어에는 세계가 필요합니다. 사진에는 움직임이 필요합니다. 제품·디스플레이·로케이션 이미지가 따로 있으면 하나의 샷으로 합쳐야 합니다.
아래 예시는 표준 텍스트→영상, 표준 이미지→영상, 표준 참조→영상, Lite 텍스트→영상, Lite 이미지→영상 순입니다. 각각이 다른 창작 과제를 보여 줍니다. 장면·길이·입력이 다르므로, 표준과 Lite의 통제된 순위가 아니라 쇼케이스로 봐 주세요.
1. Grok Imagine Video 1.5는 워크플로에 무엇을 더하나요?
xAI의 출시 발표는 움직임·물리·오디오 개선을 강조하며, 더 일관된 움직임과 액션에 더 잘 맞는 효과음·환경음·대사를 포함합니다. 이는 제공사의 설명이며, 아래 예시는 구체적 창작 과제에서 무엇이 일어났는지를 보여 줍니다. 공식 발표.
Kinovi에서 다섯 옵션은 세 가지 입력 모드와 두 가지 버전에 걸쳐 있습니다.
- 텍스트→영상(Text-to-video): 컨셉 샷, 스토리 오프닝, 프로모션 아이디어 등 글로 된 설명에서 장면을 만듭니다.
- 이미지→영상(Image-to-video): 기존 이미지에서 시작합니다. 표준 옵션은 종료 프레임도 받습니다. Lite는 시작 이미지 한 장을 사용합니다.
- 참조→영상(Reference-to-video): 여러 이미지로 캐릭터·제품·환경을 지정하면서 새 샷을 구성합니다. 이 모드는 현재 Kinovi의 표준 옵션을 통해 제공됩니다.
표준과 Lite 선택은 요금과 기능 모두와 관련됩니다. Lite는 게시된 단가가 더 낮습니다. 여러 비주얼 참조나 종료 프레임 같은 요구사항은 버전 이름보다 먼저 입력 모드 선택을 이끌어야 합니다.
2. 사양과 현재 요금
다음 정보는 2026년 10월 21일 Kinovi 모델 페이지와 대조했습니다. 각 옵션은 상세 페이지로 연결됩니다.
| 옵션 | 입력 | 길이 | 출력 해상도 | 주요 구분 |
|---|---|---|---|---|
| Standard text-to-video | 텍스트 | 1–15초 | 480p / 720p / 1080p | 텍스트로 장면 구성 |
| Standard image-to-video | 시작 이미지; 종료 이미지는 선택 | 1–15초 | 480p / 720p / 1080p | 종료 이미지 사용 시 최대 720p |
| Standard reference-to-video | 참조 이미지 1–7장과 텍스트 | 1–15초 | 480p / 720p | 비주얼 참조 결합 |
| Lite text-to-video | 텍스트 | 1–15초 | 480p / 720p / 1080p | 게시 단가가 더 낮음 |
| Lite image-to-video | 시작 이미지 한 장; 텍스트는 선택 | 1–15초 | 480p / 720p / 1080p | 단일 이미지 애니메이션 |
다섯 옵션 모두 오디오 트랙을 지원하며 4,000자 프롬프트 한도를 게시합니다. 텍스트→영상과 참조→영상은 여러 화면비를 지원합니다. 단일 이미지 애니메이션은 입력 이미지와 옵션의 프레이밍 동작을 따릅니다. 표준 이미지→영상의 화면비 매개변수는 종료 이미지가 제공될 때만 사용됩니다.
같은 출력 해상도 라벨이라도 렌더링 과정이 같다고 볼 수 없습니다. xAI의 현재 문서는 표준 텍스트→영상과 이미지→영상이 네이티브 1080p를 지원하고, Lite는 720p를 업스케일해 1080p에 도달한다고 설명합니다. 공식 영상 문서.
생성된 영상 1초당 요금
아래 금액은 모두 결과 대기 초수가 아니라 출력 영상 1초당 USD입니다.
| 옵션 | 480p | 720p | 1080p |
|---|---|---|---|
| Standard text-to-video | $0.0501 | $0.0878 | $0.1567 |
| Standard image-to-video | $0.0501 | $0.0878 | $0.1567 |
| Standard reference-to-video | $0.0501 | $0.0878 | 미지원 |
| Lite text-to-video | $0.0125 | $0.0188 | $0.0878 |
| Lite image-to-video | $0.0125 | $0.0188 | $0.0878 |
예를 들어 현재 720p 단가 기준으로 8초 표준 클립은 8 × $0.0878 = $0.7024, 8초 Lite 클립은 8 × $0.0188 = $0.1504입니다. 이는 설명용 계산이며 아래 클립의 실제 청구액이 아닙니다. 가격 관계는 해상도마다 달라지므로, 하나의 절감 비율을 모든 티어에 적용해서는 안 됩니다.
표준 텍스트→영상과 이미지→영상 페이지는 요금을 **Preview test pricing(프리뷰 테스트 요금)**으로 표시합니다. 제출 시 표시되는 금액과 선택한 옵션에 적용되는 실패/환불 조건을 확인하세요.
Grok Imagine Video 1.5: 플랫폼별 요금 비교
이 비교는 표준 Grok Imagine Video 1.5만 다루며 Lite와 구형 모델은 제외합니다. 2026년 10월 21일 확인. 해상도 열은 멤버십 환산·보너스 크레딧·구독 할인을 포함하지 않은 공개 사용량 기반 요금으로 출력 영상 1초당 USD를 보여 줍니다. 요금 출처는 표 아래에 있습니다.
| 플랫폼 | 480p | 720p | 1080p | 추가 입력 이미지 요금 | 요금 적용 범위 |
|---|---|---|---|---|---|
| Kinovi | $0.0501 | $0.0878 | $0.1567(텍스트/이미지) | 페이지에 항목화되지 않음; 제출 시 확인 | 텍스트와 이미지; 참조→영상은 최대 720p |
| Kie | ≈ $0.012 | ≈ $0.0225 | 공개 단가 미검증 | 페이지에 항목화되지 않음; 제출 시 확인 | 이미지→영상 페이지에 게시된 1.5 Preview 요금 |
| Higgsfield | $0.08 | $0.14 | $0.25 | 별도 과금 미검증 | 1.5 API 모델 패밀리 요금; 아래 모드 조건을 참고 |
| fal | $0.08 | $0.14 | $0.25(텍스트/이미지) | 입력 이미지당 $0.01 | 텍스트와 이미지; 참조→영상은 최대 720p |
| Segmind | $0.108 | $0.189 | $0.3375(텍스트/이미지) | 입력 이미지당 $0.0135 | 텍스트와 이미지; 참조→영상은 최대 720p |
| WaveSpeed | $0.08 | $0.14 | $0.25(텍스트/이미지) | 단일 이미지 모드: $0.01/요청; 참조 모드: $0.01/이미지 | 텍스트와 이미지; 참조→영상은 최대 720p |
| xAI official | $0.08 | $0.14 | $0.25(텍스트/이미지) | 입력 이미지당 $0.01 | 텍스트와 이미지; 참조→영상은 최대 720p |
요금 출처: Kinovi · RunningHub · Kie · Higgsfield · fal · Segmind · WaveSpeed · xAI official
비교에 영향을 주는 조건:
- Kinovi: 표준 텍스트→영상과 이미지→영상은 게시된 Preview test pricing을 사용합니다. 참조 모드 요금은 Kinovi reference-to-video 페이지에서도 확인할 수 있습니다. 항목화되지 않은 이미지 요금을 0으로 가정해서는 안 됩니다.
- RunningHub: 카탈로그는
xai/grok-imagine-video-v1.5/.../stable공식 stable 경로에 대해 해상도별 없이 $0.08/s를 게시합니다. 이 금액을 모든 티어에 적용할 수 없습니다. 별도의xai/grok-imagine-v1.5/...economy 경로는 $0.03/s를 보이지만, 해상도 요금과 대응 기능은 미검증이므로 티어 가격이 아니라 별도로 적습니다. - Kie: 페이지는
grok-imagine-video-1-5-preview를 식별하고 480p와 720p에 대해 2.4 및 4.5 credits/s를 게시합니다. 표는 보너스 크레딧 없이 페이지의 대략적 달러 환산을 사용합니다. 1080p가 옵션으로 나타나지만 가격은 검증되지 않았습니다. 다른 모델 요금으로 대체하지 않습니다. Preview 표기와 각 플랫폼 서비스 조건은 따로 확인하세요. - Higgsfield: 크리에이터 구독 환산이 아니라 공개 API 모델 패밀리 요금입니다. 페이지는 480p/720p의 1초 클립과 1080p의 15초 클립으로 요금을 예시합니다. 모든 길이·참조 모드·추가 입력에 동일 조건이 성립한다고 볼 수 없습니다.
- 모드와 추가 요금: 참조 모드 해상도 한도와 이미지 요금은 fal reference-to-video, Segmind reference-to-video, WaveSpeed reference-to-video 페이지에 문서화되어 있습니다. Segmind text-to-video 요금 페이지는 표와 설명문의 금액이 어긋납니다. 이 비교는 명시된 요금표를 사용합니다. 제출 전에 요금을 확인하세요.
합계를 추정하려면 공개된 입력 요금을 영상 생성 요금에 더하세요. 예를 들어 xAI 공식 가격으로 입력 이미지 한 장이 있는 8초·720p 클립은 8 × $0.14 + $0.01 = $1.13입니다. 텍스트만 생성하는 경우 입력 이미지 요금은 없습니다. “미검증”은 “미지원”이나 “무료”를 뜻하지 않습니다. 이 수치는 예산 참고용이며, 제출 시 표시되는 가격과 서비스 조건이 우선합니다.
3. 다섯 가지 예시(모델 순서)
각 예시에는 제공된 영상, 해당되는 경우 입력 이미지, 원본 영어 프롬프트가 포함됩니다. 프롬프트 안의 대사와 타이밍 지시는 의도한 출력을 설명한 것이며, 생성된 오디오의 축어 전사가 아닙니다. 비주얼 코멘트는 샘플링한 프레임에 기반하며, 파일 세부 정보는 미디어 메타데이터에서 가져왔습니다. 단어 단위 음성이나 립싱크 측정은 수행하지 않았습니다.
| 순서 | 옵션 | 예시 | 대략적 파일 길이 | 파일 치수 |
|---|---|---|---|---|
| 1 | Standard text-to-video | 구름 위 꽃집 | 15초 | 848 × 480 |
| 2 | Standard image-to-video | 사진 속 해변으로 들어가기 | 6초 | 848 × 480 |
| 3 | Standard reference-to-video | 시계 광고 | 8초 | 752 × 416 |
| 4 | Lite text-to-video | 달 세탁소 | 8초 | 848 × 480 |
| 5 | Lite image-to-video | 패션 포트레이트 | 15초 | 736 × 400 |
이는 받은 파일의 치수이며, 모델의 최대 능력이나 모든 원본 제출 설정의 증거가 아닙니다. 다섯 파일 모두 24 fps이며 오디오 트랙을 포함합니다.
1. Standard text-to-video: 구름 위 꽃집
시작 이미지나 참조 에셋은 없습니다. 컨셉은 텍스트로 시작합니다. 블루아워의 고층 테라스, 구름 위 꽃집, 따뜻한 실용 조명, 꽃을 정리하는 플로리스트. 프롬프트는 카메라 앞 대사, 빛나는 꽃, 넓은 설정을 드러내는 마지막 카메라 이동도 지정합니다.
Mode: Standard text-to-video
Input: 텍스트만; 참조 이미지 없음.
File: 약 15초 · 848 × 480 · 24 fps · 오디오 트랙 있음
Example video
Original generation prompt
Create a 15-second, 16:9 cinematic promotional film with photorealistic materials and one continuous shot. A boutique flower shop occupies a high-rise terrace above a sea of clouds at blue hour. Small amber lights illuminate a wooden workbench, plain ceramic vases, and ivory flowers. Soft foreground petals partly conceal the view. Only a hint of the clouds and distant city lights is visible at first; save the wide reveal for the ending.

The florist is an adult East Asian woman around 28, with short dark hair, a smoky-gray linen apron, and a cream shirt. Her manner is calm and confident. From 0 to 2 seconds, the camera slides gently past the foreground petals. She places one ivory flower into a vase. Its center begins to emit a subtle warm glow, no brighter than a small night-light, casting believable light on her fingertips. The flower retains its physical botanical shape; it does not dissolve or become particles.

From 2 to 12.5 seconds, settle into a steady eye-level medium shot with her face and mouth clearly visible. Looking into the lens, she speaks in warm, clear English: “This flower shop above the clouds began as words. I brought it to life with Grok one point five text-to-video on Kinovi.” She briefly glances at the flower, then returns her gaze to the camera. All speech comes directly from the visible woman, with accurate lip sync and natural pauses, not from an off-screen narrator.

From 12.5 to 15 seconds, after the dialogue, slowly pull back to reveal the cloud-filled skyline beyond the terrace. Keep the florist and shop within the composition and settle on a quiet, complete final image.

Soft side lighting, realistic skin, tactile wood and linen, restrained deep-blue and warm-gold color contrast. The glowing flower center is the only close-range magical effect. Clear voice, a delicate stem-against-ceramic sound, faint high-altitude wind, and a very quiet atmospheric music bed beneath the dialogue. No subtitles, titles, readable signs, logos, or added text. Avoid frantic cuts, exaggerated acting, heavy bloom, floating particles, and complicated hand gestures.
출력이 보여 주는 것
오프닝부터 이미 구름 풍경이 보입니다. 플로리스트는 빛나는 꽃을 꽃병에 넣고, 중반에는 카메라를 바라보며, 카메라가 물러나 작업대와 가게가 더 드러나는 동안에도 화면에 남습니다. 차가운 파란 주변과 따뜻한 꽃이 분명한 시각적 초점을 만듭니다.
결과는 모든 세부 사항을 문자 그대로 따르지 않습니다. 프롬프트는 넓은 구름 리빌을 엔딩에 남기라고 하지만, 배경의 상당 부분이 처음부터 보입니다. 빛 또한 꽃 중심에 머무르지 않고 꽃잎 전체로 퍼집니다. 큰 창작 아이디어는 전달되지만, 리빌과 조명 지시에서는 벗어납니다.
이 접근이 맞는 경우
프로모션 컨셉, 상상 속 로케이션, 브랜드 스토리 샷에 유용한 방향입니다. 프롬프트를 설정·액션·대사·최종 구도로 정리하면 결과를 평가하기 쉬워집니다.
2. Standard image-to-video: 사진 속 해변으로 들어가기
이 예시는 분명한 시작과 목적지를 제공합니다. 시작 이미지는 이젤 옆의 포토그래퍼, 종료 이미지는 석양 해변입니다. 과제는 그 공간들을 연결하고, 사진 속 파도를 움직이며, 카메라를 해안 장면으로 들이는 것입니다.
Mode: Standard image-to-video
Input: 아래에 보이는 프레임 쌍을 사용합니다. 스튜디오 포트레이트가 시작 프레임, 석양 해안이 종료 프레임입니다.
File: 약 6초 · 848 × 480 · 24 fps · 오디오 트랙 있음
Example video
Input images
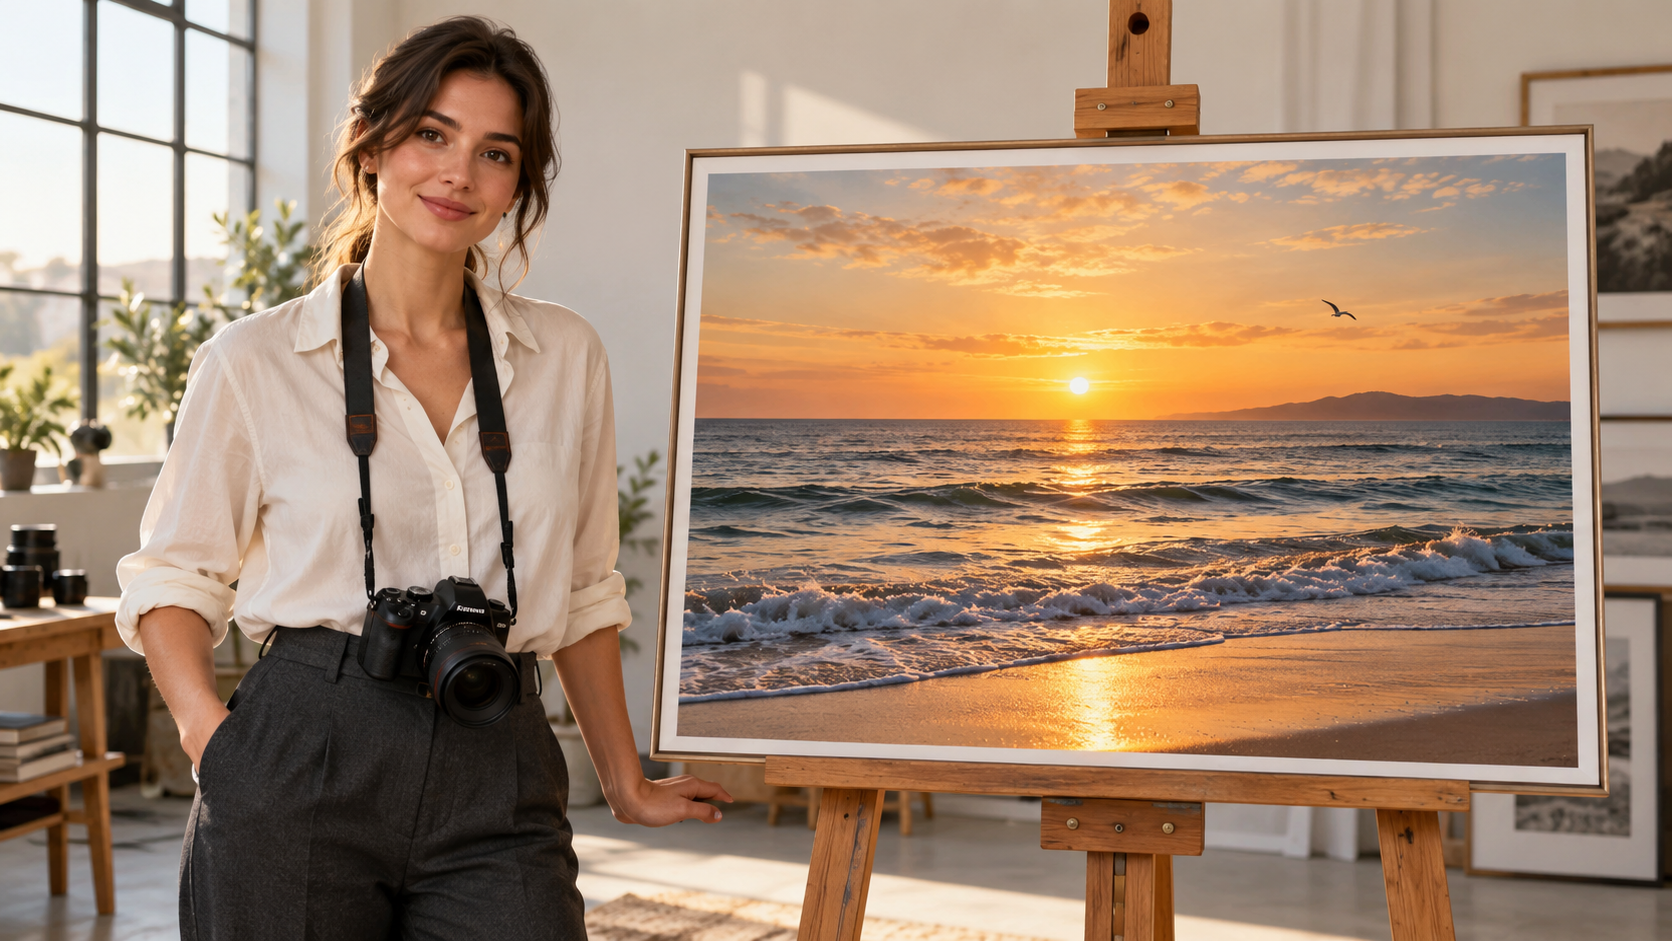
시작 프레임: 포토그래퍼와 액자 속 바다 풍경
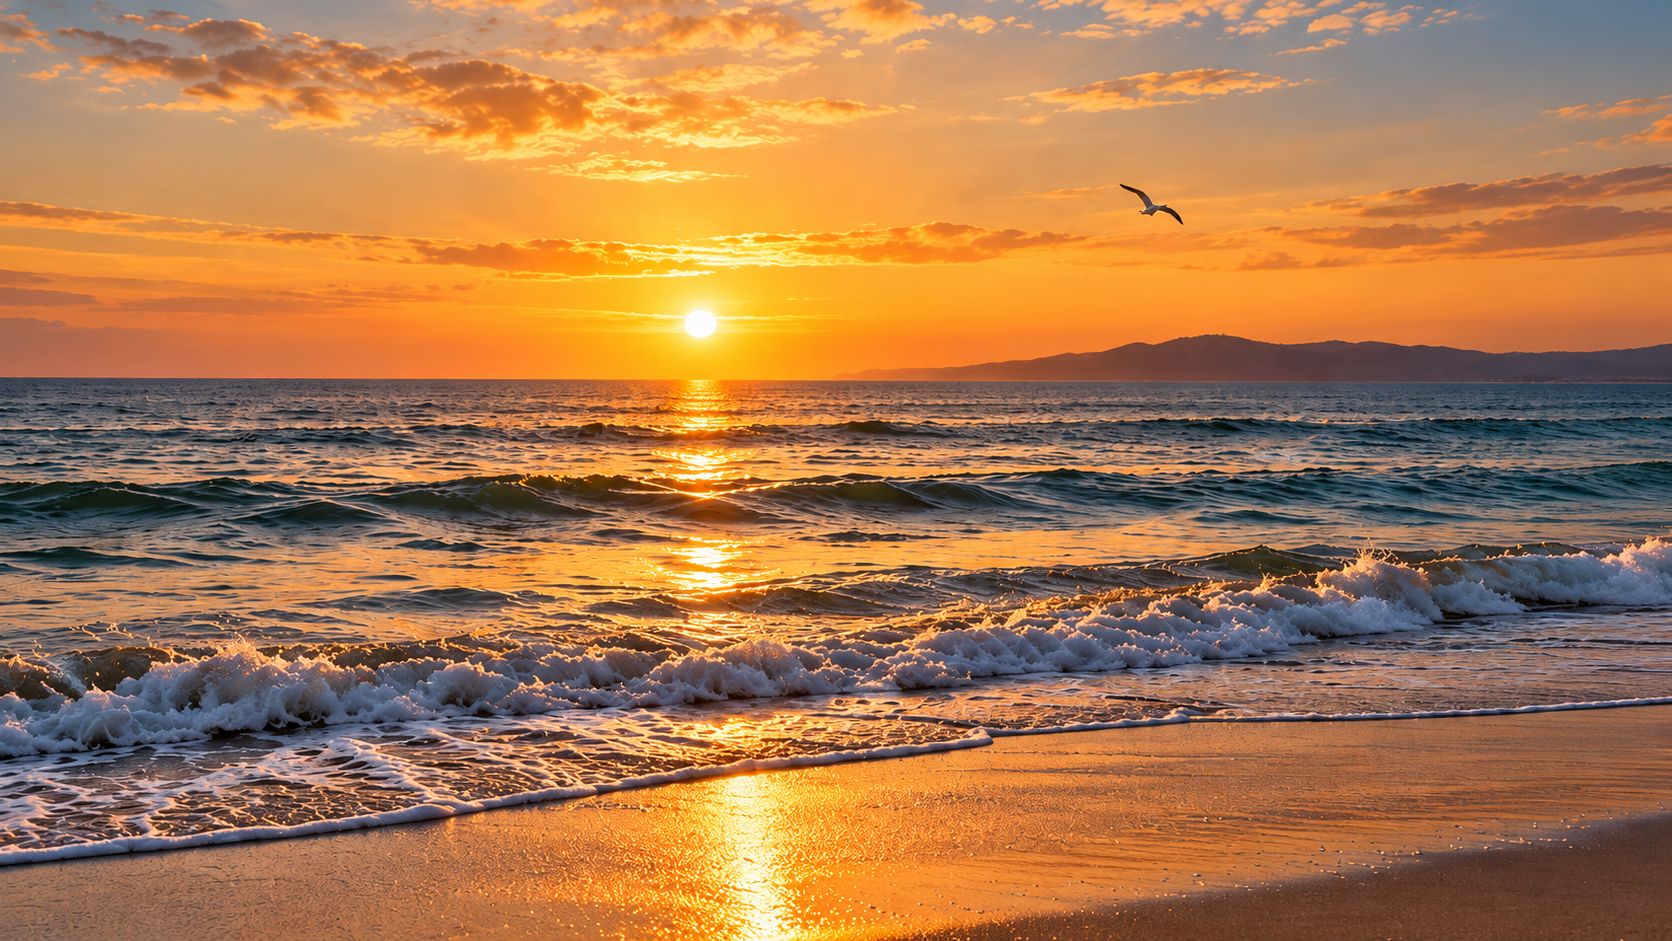
종료 프레임: 석양 해안
Original generation prompt
Photorealistic cinematic style, set in a modern photography studio. A young adult female photographer stands beside an easel displaying a photograph of a beach at sunset. She looks at the photograph, then turns toward the camera and smiles. She speaks in English:
“Let’s bring this photo to life! I made this on Kinovi using the grok-imagine-video-1.5 image-to-video model.”
As she gently gestures toward the photograph, the camera slowly pushes in. The waves within the photograph begin to roll naturally, sunlight shimmers across the water, and a seagull flies through the scene. The photograph’s frame gradually moves out of view until the moving seaside scene fills the entire screen. Natural gestures, accurate lip synchronization with the English dialogue, soft lighting, and a seamless transition. Clear voice audio accompanied by gentle ocean sounds. No added subtitles.
출력이 보여 주는 것
약 6초 출력에서 포토그래퍼는 미소 짓고, 입을 움직이며, 사진을 향해 제스처합니다. 카메라가 프레임에 다가가는 동안 파도가 바뀌고, 끝에는 스튜디오와 액자가 화면 밖으로 나가며 해안이 화면을 채웁니다. 제공된 두 구도 사이의 전환이 결과에 드러납니다.
이 클립은 프레임 간 비주얼 연속성을 보여 줍니다. 프롬프트는 영어 대사도 요청하지만, 입 움직임만으로는 문장 전체가 전달되었는지, 단어 단위로 동기화되었는지를 확정할 수 없습니다. 이렇게 짧은 런타임에서는 대사 완성을 따로 확인해야 합니다.
이 접근이 맞는 경우
사진 애니메이션, 여행 비주얼, 그려진 세계로의 전환에 유용합니다. 두 프레임 사이의 의도된 연결을 정의하고, 카메라 이동과 발화 모두에 충분한 시간을 남겨 두세요.
3. Standard reference-to-video: 시계·받침대·실내를 결합하기
참조→영상은 별도의 제품·디스플레이·로케이션 에셋을 한 장면으로 가져올 수 있습니다. 이 시계 컨셉은 각 이미지에 역할을 할당한 뒤, 다이얼 클로즈업, 케이스 주변 시점, 넓은 마무리 샷을 요청합니다.
Mode: Standard reference-to-video
Input: 이 순서로 업로드: IMAGE_0 시계, IMAGE_1 대리석 받침대, IMAGE_2 실내. 프롬프트 라벨도 같은 순서를 가리킵니다.
File: 약 8초 · 752 × 416 · 24 fps · 오디오 트랙 있음
Example video
Input images
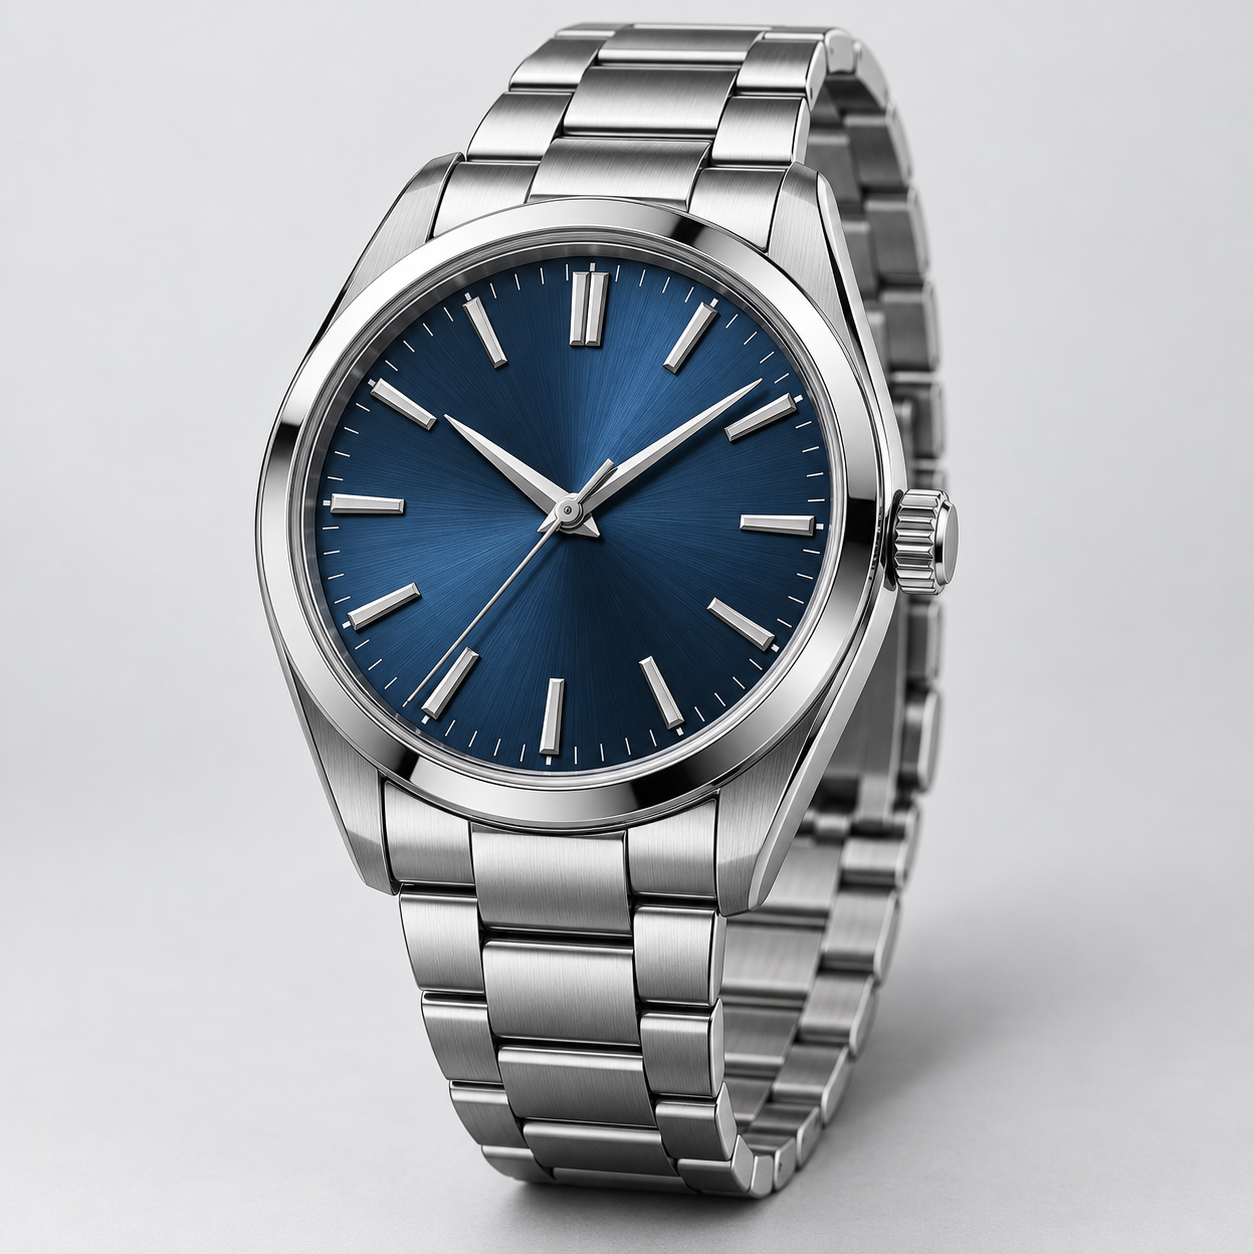
IMAGE_0: 실버 케이스와 블루 다이얼
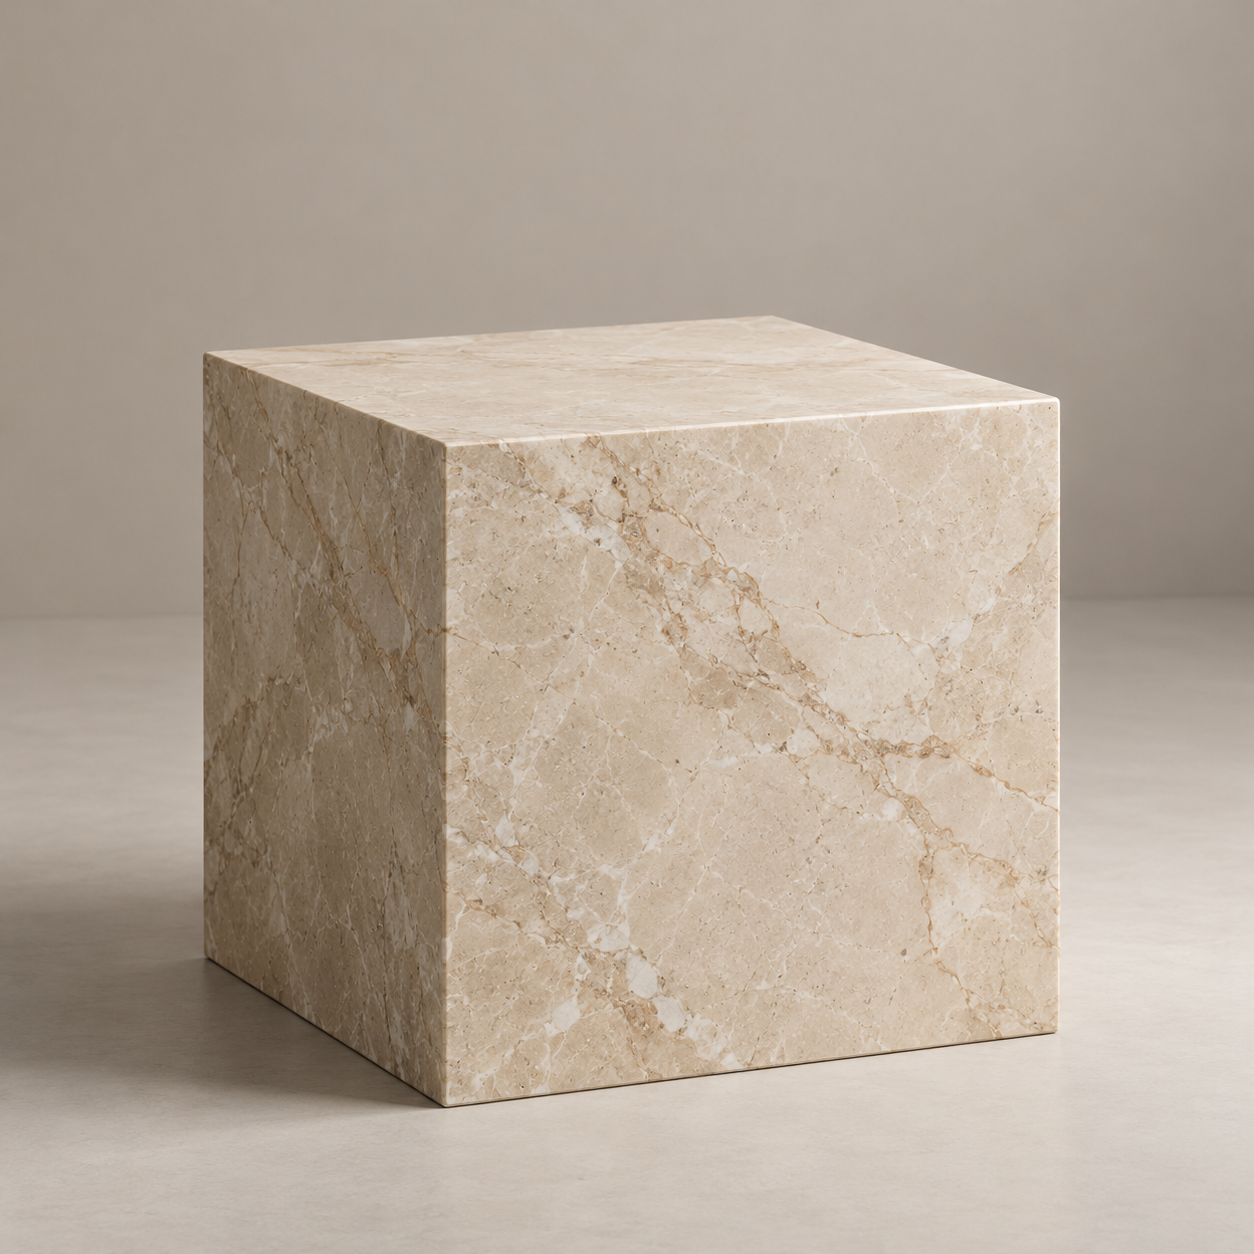
IMAGE_1: 베이지 대리석 받침대
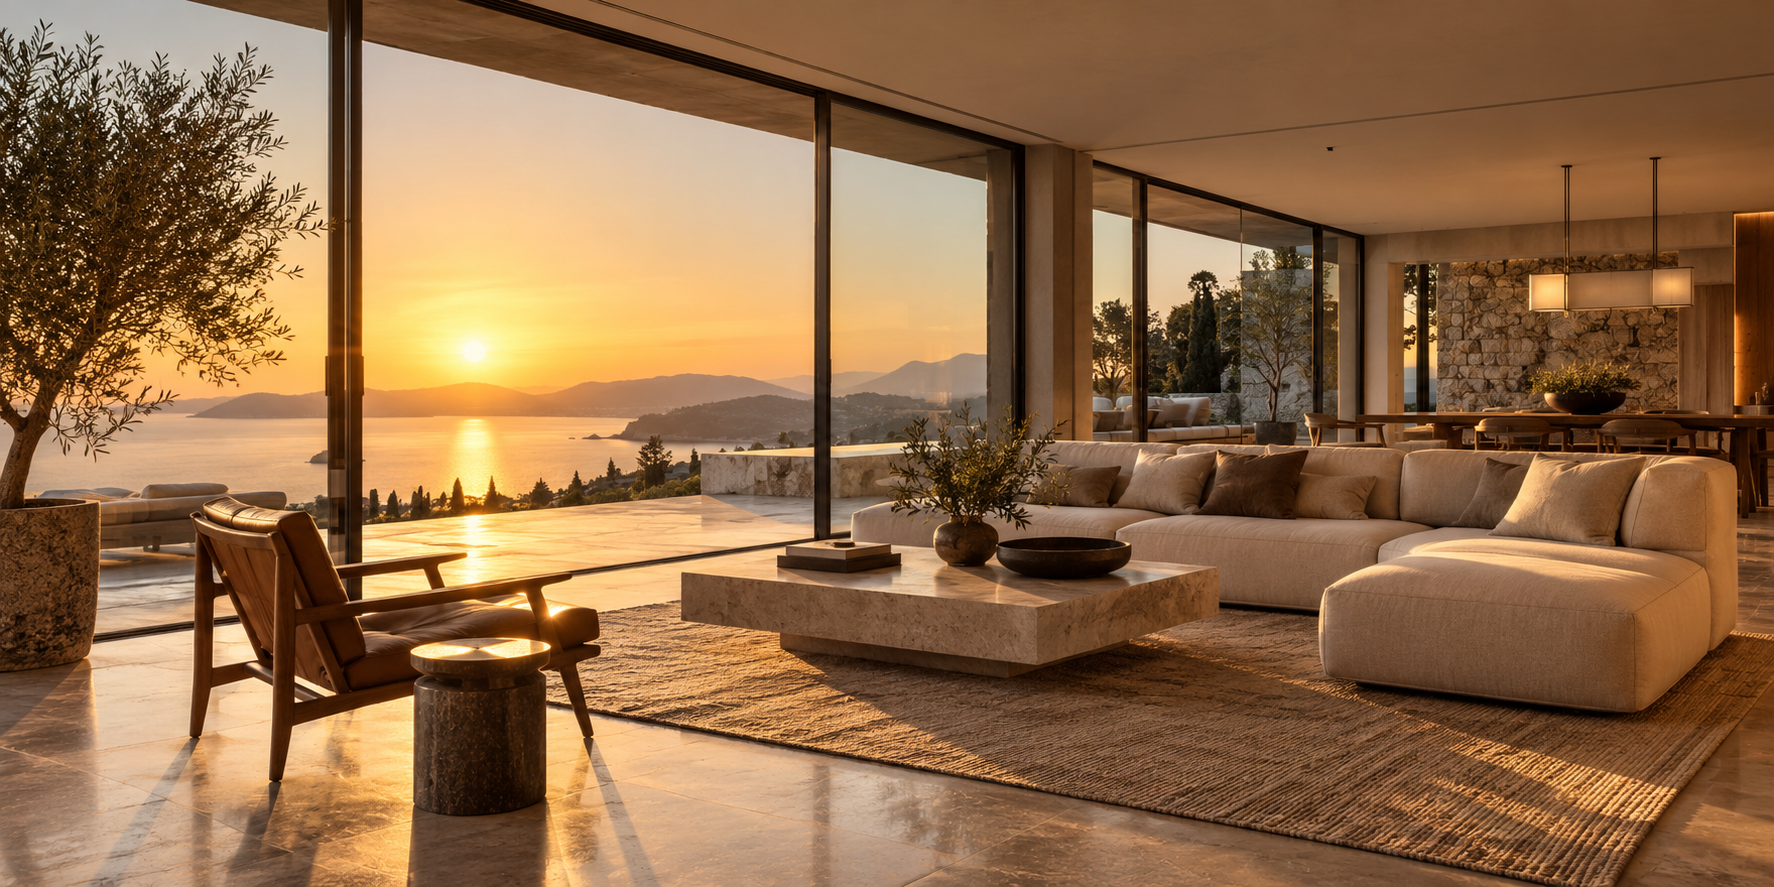
IMAGE_2: 골든아워 실내
Original generation prompt
Create an 8-second luxury watch commercial by combining three reference images.

<IMAGE_0> is the exact watch product reference. Preserve its silver metal case, blue dial, hands, hour markers, crown placement and bracelet design.
<IMAGE_1> defines the beige marble pedestal and its surface texture.
<IMAGE_2> defines the warm golden-hour interior environment and lighting.

Place the exact watch from <IMAGE_0> upright on the marble pedestal from <IMAGE_1>, inside the setting from <IMAGE_2>.

0–2s: Extreme close-up of the watch dial. Fine metallic reflections reveal the watch's craftsmanship.

2–5s: The camera performs a slow cinematic orbit around the watch, revealing the case thickness, crown and metallic bracelet without altering their original geometry.

5–8s: The camera pulls back to reveal the watch resting on the marble pedestal, with warm sunlight and realistic shadows across the surface.

Maintain exact watch identity and material details throughout. Physically accurate metal reflections, consistent dial markings, realistic contact shadows and correct perspective.

Audio: Subtle mechanical ticking, luxurious ambient music and a gentle final musical accent.

No added logos, no invented text, no product redesign. 16:9.
출력이 보여 주는 것
출력은 블루 다이얼 가까이에서 시작해 크라운·케이스·브레이슬릿을 드러낸 뒤, 대리석 표면 위에 선 시계로 물러납니다. 제품·디스플레이·따뜻한 실내라는 세 가지 주요 요소가 모두 표현됩니다.
다만 제품은 완전한 복제가 아닙니다. 제공된 시계에는 날짜창이 없는데, 생성된 클로즈업에는 날짜창/확대경 기능이 나타납니다. 예시는 다중 이미지 구성과 광고 샷 설계를 보여 주지만, 완벽한 제품 충실도를 확립하지는 않습니다. 제품 광고에 쓰기 전에 다이얼 세부, 마커, 크라운 위치, 브레이슬릿 구조를 따로 점검하세요.
이 접근이 맞는 경우
제품 스테이징 제안과 광고 컨셉에 유용합니다. 각 참조에 명시적 역할을 할당하고, 클립을 충실한 제품 시연으로 다루기 전에 생성된 제품 세부 사항을 검사하세요.
4. Lite text-to-video: 새벽 2시, 달을 세탁하기
우주비행사, 세탁소, 달이 하나의 설정을 공유합니다. 캐릭터는 거의 정지해 있고, 카메라·드럼·물이 그 주위에서 움직이며 하나의 초현실적 초점을 만듭니다.
Mode: Lite text-to-video
Input: 텍스트만; 참조 이미지 없음.
File: 약 8초 · 848 × 480 · 24 fps · 오디오 트랙 있음
Example video
Original generation prompt
An 8-second cinematic shot inside a quiet, slightly worn neighborhood laundromat at 2 a.m. Rain streaks the storefront windows. A single astronaut sits motionless on a plastic chair, holding an empty laundry basket.

Inside the oversized circular window of the central washing machine, a luminous three-dimensional moon slowly rotates like a heavy object in a wash cycle. Its craters remain clearly visible. A thin ring of water slides around the bottom of the drum, catching silver moonlight.

The camera makes one slow, deliberate push toward the machine. Its warm interior glow gently illuminates the astronaut's visor and the scratched tile floor, contrasting with the cool fluorescent ceiling lights.

Treat this impossible scene with understated photographic realism: restrained colors, tactile surfaces, subtle film grain, controlled highlights. The moon stays inside the drum throughout. One continuous shot, no cuts.

Audio: a low mechanical hum, water softly sloshing, distant rain. No dialogue or music.
출력이 보여 주는 것
우주비행사가 바구니을 들고 앉아 있는 동안 카메라가 다가갑니다. 밝은 달은 큰 드럼 안에 머물고, 따뜻한 빛이 젖은 바닥에 반사됩니다. 구도는 달의 세탁이 끝나기를 기다리는 아이디어를 분명히 전달합니다.
출력은 또한 드럼에서 물이 흘러나와 바닥에 고이는 장면을 더해, 프롬프트의 “기기 안 얇은 물 고리”를 넘어갑니다. 달 표면의 변화만으로는 물리적으로 일관된 3차원 회전을 검증하기에 부족합니다. 비주얼 아이디어를 확립하면서도, 모델이 세부 사항을 덧붙일 수 있음을 보여 줍니다.
이 접근이 맞는 경우
예산 친화적 비주얼 아이디어, 분위기 샷, 소셜 클립을 탐색하는 방향입니다. 이 장면은 표준 텍스트→영상 예시와 다르므로, 품질의 통제된 비교가 아닙니다.
5. Lite image-to-video: 패션 포트레이트에 생기를 더하기
선택된 시작 참조는 출력의 아이보리 수트와 테라스 설정과 일치합니다. 인물·의상·의자·벽·얇은 커튼이 이미 정의되어 있으므로, 영상은 작은 표정 변화, 머리카락, 직물에 초점을 둡니다.
Mode: Lite image-to-video
Input: 시작 이미지 한 장: 테라스에서 아이보리 수트를 입고 앉은 여성.
File: 약 15초 · 736 × 400 · 24 fps · 오디오 트랙 있음
Example video
Input images
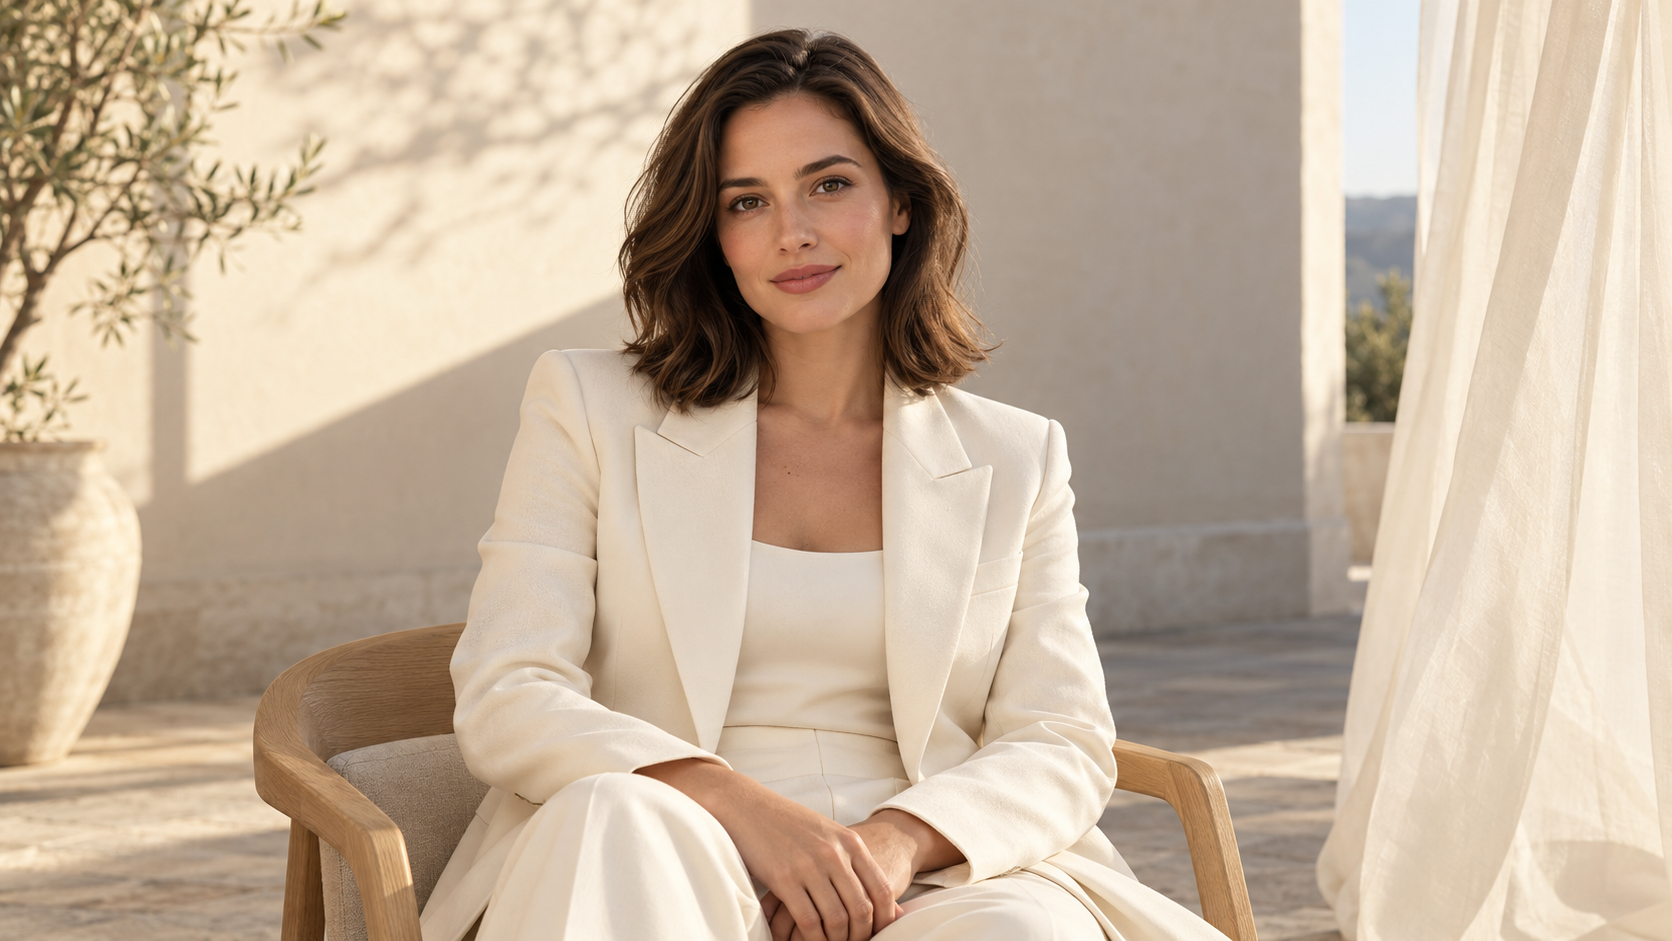
시작 프레임: 아이보리 수트 테라스 포트레이트
Original generation prompt
Use the uploaded portrait as the first frame of a 15-second, 16:9 premium fashion talking-portrait film. Preserve the adult woman’s identity, hairstyle, ivory suit, seated pose, chair, architectural terrace, warm-white wall, sheer curtain, and original composition. Use a locked, eye-level medium shot. Do not change her outfit, location, or identity.

From 0 to 2 seconds, begin naturally from the input image. A gentle breeze moves a few strands of hair beside her ear and the translucent ivory curtain at the side of the frame. Keep the curtain near the image edge, never over her face. She blinks softly, with subtle, natural breathing through her shoulders.

From 2 to 12.5 seconds, she looks into the lens and speaks in composed, confident English: “A portrait can have a cinematic sense of life. I made this with Grok one point five Lite image-to-video on Kinovi.” Her delivery feels like a model sharing a creative moment after a shoot, not a loud sales pitch. Use clear diction and natural pauses. The visible woman speaks the entire line with accurate lip sync. Keep her hands relaxed and use only small eye and head movements; no waving.

From 12.5 to 15 seconds, after the dialogue, she briefly looks toward the sunlight at the side and returns to the camera with a faint smile. The hair and curtain continue moving gently. Hold the camera still and end on the complete fashion-portrait composition.

Champagne-colored side light, soft geometric shadows, realistic skin and suit fabric, and layered, restrained warm whites. No excessive beauty filtering, plastic skin, or strong lens flares. Clear speech, gentle wind, and a very quiet original sparse-piano bed beneath the voice. No off-screen narration, subtitles, magazine cover text, logos, or added on-screen lettering. Maintain stable facial features and clothing. No large head turns or curtain passing through the body.
출력이 보여 주는 것
약 15초 클립은 앉은 피사체를 중심으로 유지합니다. 샘플링한 프레임에서 아이보리 수트, 의자, 따뜻한 흰색 설정이 인식됩니다. 입과 표정이 바뀌고, 커튼이 움직이며, 끝은 더 고요한 표정으로 돌아갑니다.
클립은 기존 포트레이트의 섬세한 애니메이션을 보여 줍니다. 인식 가능한 의과 주변이 있어도 프레임 완벽한 아이덴티티 보존을 확립하지는 않습니다. 대사 완성, 발음, 시청각 동기화도 별도 재생 확인이 필요합니다.
이 접근이 맞는 경우
자기소개, 패션 포트레이트 애니메이션, 절제된 토킹헤드에 유용한 설정입니다. 분명한 시작 이미지와 작은 움직임 세트가 의도한 결과를 정의하기 쉽게 만듭니다.
4. Kinovi에서 만들기 시작하기
- 입력 모드를 고릅니다. 아이디어에는 텍스트→영상, 기존 구도에는 이미지→영상, 여러 비주얼 에셋에는 참조→영상을 사용합니다.
- 소재를 준비합니다. 시작 이미지는 선명하게, 종료 이미지는 의도적으로. 참조는 업로드 순서를 일관되게 유지하고 프롬프트에서 각 이미지에 역할을 할당합니다.
- 길이와 출력 품질을 설정합니다. 발화와 카메라 이동 모두에 시간을 남깁니다. 해상도, 오디오, 지원 프레이밍 설정, 현재 가격을 확인합니다.
- 프로젝트에 중요한 점을 검토합니다. 인물이면 얼굴·손·입 움직임, 제품이면 형태·문자·소재, 전환이면 시작·끝·중간 움직임을 점검합니다.
생성 옵션 열기
- Standard text-to-video
- Standard image-to-video
- Standard reference-to-video
- Lite text-to-video
- Lite image-to-video
5. 핵심: 먼저 워크플로를 고르고, 그다음 버전을 평가하세요
다섯 영상은 서로 다른 종류의 소재에서 시작합니다. 꽃집은 텍스트로 장면을 만들고, 스튜디오 클립은 두 구도를 연결하며, 시계 광고는 참조를 결합하고, 달 세탁소는 Lite의 낮은 게시 단가로 초현실 컨셉을 탐색하며, 패션 포트레이트는 기존 인물과 설정을 확장합니다.
과제부터 시작하세요. 여러 참조나 종료 프레임이 필요하면 해당 표준 옵션을 확인하세요. 텍스트 기반 아이디어나 단일 이미지 애니메이션이라면 시도에 Lite를 포함하세요. 그다음 같은 과제의 출력을 비교해 디테일·화질·비용이 필요에 맞는지 판단합니다.
설득력 있는 분위기가 모든 지시를 따랐다는 뜻은 아니며, 매력적인 광고가 정확한 제품을 보장하지도 않습니다. 유용한 워크플로는 창의적 생성과 게시 전 세심한 검토 모두를 위한 여지를 둡니다.
6. 자주 묻는 질문
1. 이 다섯 가지는 완전히 별개의 모델인가요?
더 실용적인 이해는 표준과 Lite라는 두 버전에 서로 다른 입력 모드가 붙는 것입니다. Kinovi는 과제별로 고를 수 있도록 별도 옵션으로 게시합니다.
2. 이미지→영상과 참조→영상은 어떻게 다른가요?
이미지→영상은 특정 구도에서 시작하며, 표준 옵션은 종료 프레임도 받을 수 있습니다. 참조→영상은 첫 참조를 자동으로 고정 시작 프레임으로 다루지 않고, 피사체·제품·환경을 정의하기 위해 이미지를 사용합니다. 한쪽은 구도를 확장하고, 다른 쪽은 비주얼 소스를 결합합니다.
3. 영상에 대사와 환경음을 넣을 수 있나요?
다섯 옵션 모두 오디오 생성을 제공합니다. 프롬프트로 대사·환경음·효과·음악을 요청할 수 있지만, 발화 완성·발음·동기화는 출력에서 확인해야 합니다. 긴 대사에는 충분한 런타임이 필요합니다.
4. 모든 모드가 1080p와 시작/종료 프레임을 지원하나요?
아니요. 표준과 Lite의 텍스트→영상 및 이미지→영상은 1080p를 게시하지만, 참조→영상은 최대 720p입니다. 표준 이미지→영상은 종료 프레임 사용 시 720p로 제한됩니다. Lite 이미지→영상은 시작 이미지 한 장을 받으며, 그 1080p 출력은 업스케일입니다.
5. Lite가 표준보다 빠르거나 품질이 동등한가요?
이 예시에는 비교 가능한 생성 시간 기록이나 매칭된 과제가 없어 속도나 품질 동등성을 확립하지 않습니다. 이 글은 Lite를 xAI 발표의 Fast 버전과 동일시하지도 않습니다.
6. 비용은 어떻게 추정하나요?
선택한 옵션과 해상도의 현재 초당 단가에 출력 길이를 곱합니다. 적용되는 재시도·실패·프로모션 조건을 확인하세요. 샘플 영상 파일만으로는 그 생성에 청구된 금액을 확정할 수 없습니다.
7. 참조가 제품이 바뀌지 않음을 보장하나요?
이 예시는 그 보장을 뒷받침하지 않습니다. 시계 출력은 참조에 없는 날짜창/확대경 기능을 추가합니다. 제품 마케팅에서는 결과를 승인하기 전에 다이얼·문자·형태·구조 세부 사항을 점검하세요.
8. 프롬프트 타이밍 지시가 초 단위로 지켜지나요?
시간 범위는 페이싱을 전달하지만 정밀한 편집 타임라인은 아닙니다. 실제 생성 설정이 사용 가능한 런타임을 정하며, 모델이 배경을 일찍 드러내거나 효과를 덧붙일 수 있습니다. 필수 대사와 액션을 우선하세요.
출처 및 검증 메모
플랫폼 사양과 요금은 2026년 10월 21일에 확인했습니다. 모델 할당, 프롬프트, 입력 이미지는 제공된 케이스 자료를 따르며, 출력 길이와 치수는 파일에서 읽었습니다. 이 글을 위해 원본 영상을 편집·더빙·자막 처리하지 않았습니다. 예시는 워크플로를 보여 주는 것이며 전반적인 모델 순위를 확립하지 않습니다.
관련 글
More to try
관련 모델
ByteDance · video model
Seedance 2.0
ByteDance의 차세대 AI 비디오 모델입니다. Fast와 Pro 모드를 결합해 고품질 비디오 생성을 제공합니다.
$0.0707/s
Alibaba · video model
HappyHorse 1.0
HappyHorse 1.0은 Kinovi에서 사용할 수 있는 Alibaba의 고품질 비디오 생성 모델입니다. 텍스트-비디오, 이미지-비디오, 참조 이미지 기반 비디오, 비디오 편집 모드를 지원합니다.
$0.0801/s
ByteDance · video model
Seedance 2.5 API | 멀티모달 AI 비디오 생성 | Kinovi
Seedance 2.5는 최대 30초 생성, 멀티모달 참조, 정밀한 부분 편집을 위한 ByteDance의 차세대 AI 동영상 모델입니다.
$0.1197/s