2026 Grok Imagine Video 1.5 sur Kinovi : cinq options, des films créatifs aux pubs produit
Cinq vrais exemples vidéo avec prompts originaux et images de référence, plus les spécifications, tarifs et FAQ de Grok Imagine Video 1.5 et Lite sur Kinovi.
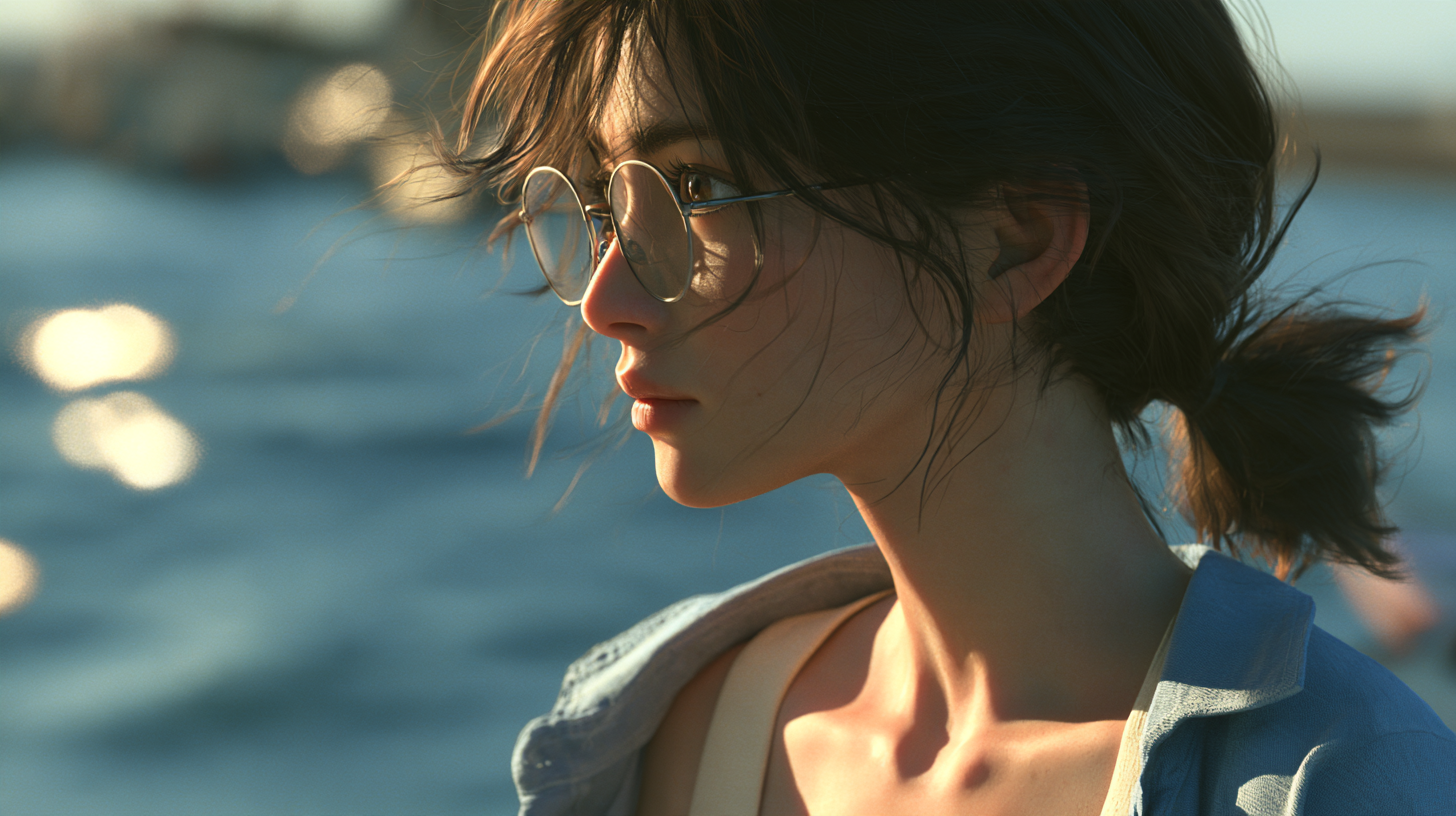
En bref : Une boutique de fleurs au-dessus des nuages, une photographie qui devient une plage en mouvement, et une pub de montre assemblée à partir de trois références visuelles : la famille Grok Imagine Video 1.5 est disponible sur Kinovi via cinq options standard et Lite. Ce guide réunit cinq vidéos existantes, leurs images d’entrée, prompts complets, spécifications et tarifs actuels pour vous aider à choisir un point de départ pour votre propre projet.
Un projet vidéo IA commence souvent par le matériel que vous avez déjà. Une idée écrite a besoin d’un monde autour d’elle. Une photographie a besoin de mouvement. Des images séparées de produit, de présentoir et de lieu doivent devenir un seul plan.
Les exemples ci-dessous suivent cet ordre : text-to-video standard, image-to-video standard, reference-to-video standard, text-to-video Lite et image-to-video Lite. Chacun illustre une tâche créative différente. Leurs scènes, durées et entrées diffèrent ; il s’agit donc d’une vitrine plutôt que d’un classement contrôlé entre standard et Lite.
1. Qu’apporte Grok Imagine Video 1.5 au flux de travail ?
L’annonce de lancement de xAI met l’accent sur des améliorations du mouvement, de la physique et de l’audio, notamment un mouvement plus cohérent et des effets sonores, une ambiance et un dialogue mieux alignés sur l’action. Ce sont les descriptions du fournisseur ; les exemples ci-dessous montrent ce qui s’est produit dans des tâches créatives concrètes. Annonce officielle.
Sur Kinovi, les cinq options couvrent trois modes d’entrée et deux versions :
- Text-to-video : Construire une scène à partir d’une description écrite, qu’il s’agisse d’un plan conceptuel, d’une ouverture d’histoire ou d’une idée promotionnelle.
- Image-to-video : Partir d’une image existante. L’option standard accepte aussi une image de fin ; Lite utilise une seule image de départ.
- Reference-to-video : Utiliser plusieurs images pour préciser un personnage, un produit ou un environnement tout en composant un nouveau plan. Ce mode est actuellement proposé via l’option standard sur Kinovi.
Choisir entre standard et Lite implique à la fois le prix et les fonctionnalités. Lite a des tarifs listés plus bas. Des besoins comme plusieurs références visuelles ou une image de fin doivent guider le choix du mode d’entrée avant le nom de la version.
2. Spécifications et tarifs actuels
Les informations suivantes ont été vérifiées sur les pages de modèles de Kinovi le 21 octobre 2026. Chaque option renvoie vers sa page de détail.
| Option | Entrée | Durée | Résolutions de sortie | Distinction clé |
|---|---|---|---|---|
| Standard text-to-video | Texte | 1–15 secondes | 480p / 720p / 1080p | Construire des scènes à partir du texte |
| Standard image-to-video | Image de départ ; image de fin optionnelle | 1–15 secondes | 480p / 720p / 1080p | Jusqu’à 720p avec une image de fin |
| Standard reference-to-video | 1–7 images de référence et texte | 1–15 secondes | 480p / 720p | Combiner des références visuelles |
| Lite text-to-video | Texte | 1–15 secondes | 480p / 720p / 1080p | Tarifs listés plus bas |
| Lite image-to-video | Une image de départ ; texte optionnel | 1–15 secondes | 480p / 720p / 1080p | Animer une seule image |
Les cinq options prennent en charge une piste audio et publient une limite de prompt de 4 000 caractères. Text-to-video et reference-to-video prennent en charge plusieurs formats d’image. L’animation à partir d’une seule image suit l’image d’entrée et le comportement de cadrage de l’option ; le paramètre de format de l’image-to-video standard n’est utilisé que lorsqu’une image de fin est fournie.
La même étiquette de résolution de sortie n’implique pas le même processus de rendu. La documentation actuelle de xAI décrit le text-to-video et l’image-to-video standard comme prenant en charge le 1080p natif, tandis que Lite atteint le 1080p par upscaling du 720p. Documentation vidéo officielle.
Tarifs par seconde de vidéo générée
Tous les montants ci-dessous sont en USD par seconde de vidéo de sortie, et non par seconde d’attente du résultat.
| Option | 480p | 720p | 1080p |
|---|---|---|---|
| Standard text-to-video | $0.0501 | $0.0878 | $0.1567 |
| Standard image-to-video | $0.0501 | $0.0878 | $0.1567 |
| Standard reference-to-video | $0.0501 | $0.0878 | Not supported |
| Lite text-to-video | $0.0125 | $0.0188 | $0.0878 |
| Lite image-to-video | $0.0125 | $0.0188 | $0.0878 |
Par exemple, aux tarifs 720p actuels, un clip standard de huit secondes coûte 8 × $0.0878 = $0.7024 ; un clip Lite de huit secondes coûte 8 × $0.0188 = $0.1504. Ce sont des calculs illustratifs, pas les factures réelles des clips ci-dessous. Le rapport de prix change selon la résolution, donc un seul ratio d’économie ne doit pas être appliqué à tous les paliers.
Les pages text-to-video et image-to-video standard étiquettent leurs tarifs Preview test pricing. Vérifiez le montant affiché à la soumission et les conditions d’échec/remboursement applicables à l’option choisie.
Grok Imagine Video 1.5 : tarifs sur les différentes plateformes
Cette comparaison porte uniquement sur Grok Imagine Video 1.5 standard, hors Lite et modèles plus anciens. Vérifiée le 21 octobre 2026. Les colonnes de résolution indiquent des USD par seconde de vidéo de sortie, à partir des tarifs publics à l’usage, sans conversions d’abonnement, crédits bonus ni remises d’abonnement. Les sources de tarification sont listées sous le tableau.
| Plateforme | 480p | 720p | 1080p | Frais supplémentaires d’image d’entrée | Portée tarifaire |
|---|---|---|---|---|---|
| Kinovi | $0.0501 | $0.0878 | $0.1567 (text/image) | Non détaillé sur la page ; vérifier à la soumission | Text et image ; reference-to-video jusqu’à 720p |
| Kie | ≈ $0.012 | ≈ $0.0225 | Public rate unverified | Non détaillé sur la page ; vérifier à la soumission | Tarifs 1.5 Preview publiés sur la page image-to-video |
| Higgsfield | $0.08 | $0.14 | $0.25 | Frais séparés non vérifiés | Tarifs famille de modèles API 1.5 ; voir qualifications de mode ci-dessous |
| fal | $0.08 | $0.14 | $0.25 (text/image) | $0.01 per input image | Text et image ; reference-to-video jusqu’à 720p |
| Segmind | $0.108 | $0.189 | $0.3375 (text/image) | $0.0135 per input image | Text et image ; reference-to-video jusqu’à 720p |
| WaveSpeed | $0.08 | $0.14 | $0.25 (text/image) | Single-image mode: $0.01/request; reference mode: $0.01/image | Text et image ; reference-to-video jusqu’à 720p |
| xAI official | $0.08 | $0.14 | $0.25 (text/image) | $0.01 per input image | Text et image ; reference-to-video jusqu’à 720p |
Sources des tarifs : Kinovi · RunningHub · Kie · Higgsfield · fal · Segmind · WaveSpeed · xAI official
Conditions qui affectent la comparaison :
- Kinovi : Les text-to-video et image-to-video standard utilisent le Preview test pricing listé. Les tarifs du mode référence sont aussi disponibles sur la page Kinovi reference-to-video. Des frais d’image non détaillés ne doivent pas être présumés nuls.
- RunningHub : Le catalogue liste $0.08/s pour les routes officielles stables
xai/grok-imagine-video-v1.5/.../stable, sans tarifs par résolution. Ce montant ne peut pas être appliqué à tous les paliers. Des routes économie séparéesxai/grok-imagine-v1.5/...affichent $0.03/s ; leur tarification par résolution et les capacités correspondantes restent non vérifiées, elles sont donc notées séparément plutôt qu’inscrites comme prix de palier. - Kie : La page identifie
grok-imagine-video-1-5-previewet liste 2.4 et 4.5 credits/s pour 480p et 720p. Le tableau utilise les équivalents dollars approximatifs de la page, sans crédits bonus. Bien que le 1080p apparaisse comme option, son prix n’a pas été vérifié ; les tarifs d’autres modèles ne sont pas substitués. Vérifiez séparément la désignation Preview et les conditions de service de chaque plateforme. - Higgsfield : Ce sont des tarifs publics de famille de modèles API, pas des conversions d’abonnement créateur. La page illustre les prix avec des clips d’une seconde en 480p/720p et de 15 secondes en 1080p. Cela n’établit pas des conditions identiques pour chaque durée, mode référence ou entrée supplémentaire.
- Modes et frais supplémentaires : Les limites de résolution du mode référence et les frais d’image sont documentés sur les pages fal reference-to-video, Segmind reference-to-video et WaveSpeed reference-to-video. La page de tarifs Segmind text-to-video présente des montants contradictoires entre son tableau et le texte explicatif ; cette comparaison utilise le tableau de tarifs explicite. Confirmez le montant avant de soumettre.
Pour estimer un total, ajoutez les frais d’entrée déclarés au coût de génération vidéo. Par exemple, le prix officiel xAI pour un clip de huit secondes en 720p avec une image d’entrée est 8 × $0.14 + $0.01 = $1.13. La génération texte seul n’entraîne pas de frais d’image d’entrée. « Unverified » ne signifie ni « non pris en charge » ni « gratuit ». Ces chiffres sont des références budgétaires ; le prix et les conditions de service affichés à la soumission prévalent.
3. Cinq exemples, dans l’ordre des modèles
Chaque exemple inclut la vidéo fournie, les images d’entrée le cas échéant, et le prompt anglais d’origine. Les instructions de dialogue et de timing dans un prompt décrivent la sortie prévue ; ce ne sont pas une transcription mot à mot de l’audio généré. Les commentaires visuels s’appuient sur des images échantillonnées, et les détails de fichier proviennent des métadonnées média. Aucune mesure de parole au niveau des mots ni de synchronisation labiale n’a été effectuée.
| Ordre | Option | Exemple | Durée approximative du fichier | Dimensions du fichier |
|---|---|---|---|---|
| 1 | Standard text-to-video | Boutique de fleurs au-dessus des nuages | 15 seconds | 848 × 480 |
| 2 | Standard image-to-video | Entrer dans une photographie de plage | 6 seconds | 848 × 480 |
| 3 | Standard reference-to-video | Pub de montre | 8 seconds | 752 × 416 |
| 4 | Lite text-to-video | Laverie lunaire | 8 seconds | 848 × 480 |
| 5 | Lite image-to-video | Portrait de mode | 15 seconds | 736 × 400 |
Ce sont les dimensions des fichiers reçus, pas les capacités maximales des modèles ni la preuve de tous les paramètres de soumission d’origine. Les cinq fichiers sont en 24 fps et contiennent une piste audio.
1. Standard text-to-video : une boutique de fleurs au-dessus des nuages
Il n’y a ni image de départ ni ressource de référence. Le concept commence en texte : une terrasse d’immeuble à l’heure bleue, une boutique de fleurs au-dessus des nuages, des lumières pratiques chaudes, et une fleuriste qui arrange une fleur. Le prompt précise aussi une réplique à la caméra, une fleur lumineuse et un mouvement de caméra final qui révèle le décor plus large.
Mode: Standard text-to-video
Input: Texte uniquement ; aucune image de référence.
File: environ 15 secondes · 848 × 480 · 24 fps · piste audio présente
Example video
Original generation prompt
Create a 15-second, 16:9 cinematic promotional film with photorealistic materials and one continuous shot. A boutique flower shop occupies a high-rise terrace above a sea of clouds at blue hour. Small amber lights illuminate a wooden workbench, plain ceramic vases, and ivory flowers. Soft foreground petals partly conceal the view. Only a hint of the clouds and distant city lights is visible at first; save the wide reveal for the ending.

The florist is an adult East Asian woman around 28, with short dark hair, a smoky-gray linen apron, and a cream shirt. Her manner is calm and confident. From 0 to 2 seconds, the camera slides gently past the foreground petals. She places one ivory flower into a vase. Its center begins to emit a subtle warm glow, no brighter than a small night-light, casting believable light on her fingertips. The flower retains its physical botanical shape; it does not dissolve or become particles.

From 2 to 12.5 seconds, settle into a steady eye-level medium shot with her face and mouth clearly visible. Looking into the lens, she speaks in warm, clear English: “This flower shop above the clouds began as words. I brought it to life with Grok one point five text-to-video on Kinovi.” She briefly glances at the flower, then returns her gaze to the camera. All speech comes directly from the visible woman, with accurate lip sync and natural pauses, not from an off-screen narrator.

From 12.5 to 15 seconds, after the dialogue, slowly pull back to reveal the cloud-filled skyline beyond the terrace. Keep the florist and shop within the composition and settle on a quiet, complete final image.

Soft side lighting, realistic skin, tactile wood and linen, restrained deep-blue and warm-gold color contrast. The glowing flower center is the only close-range magical effect. Clear voice, a delicate stem-against-ceramic sound, faint high-altitude wind, and a very quiet atmospheric music bed beneath the dialogue. No subtitles, titles, readable signs, logos, or added text. Avoid frantic cuts, exaggerated acting, heavy bloom, floating particles, and complicated hand gestures.
Ce que montre la sortie
Le paysage de nuages est déjà visible à l’ouverture. La fleuriste place la fleur lumineuse dans un vase, fait face à la caméra pendant la section centrale, et reste dans le cadre pendant que la caméra recule pour révéler davantage du plan de travail et de la boutique. Les environs bleu froid et la fleur chaude établissent un focus visuel clair.
Le résultat ne suit pas chaque détail au pied de la lettre. Le prompt réserve la grande révélation des nuages pour la fin, mais une grande partie du décor est visible dès le début. La lueur s’étend aussi sur les pétales plutôt que de rester au centre de la fleur. L’idée créative large passe, avec des écarts sur les instructions de révélation et d’éclairage.
Où cette approche convient
Une direction utile pour les concepts promotionnels, les lieux imaginés et les plans de storytelling de marque. Organiser un prompt en décor, action, dialogue et composition finale rend le résultat plus facile à évaluer.
2. Standard image-to-video : entrer dans la plage à l’intérieur d’une photographie
Cet exemple fournit un début et une destination clairs : une photographe à côté d’un chevalet dans l’image de départ, et une plage au coucher du soleil dans l’image de fin. La tâche consiste à relier ces espaces, animer les vagues à l’intérieur de la photographie et faire entrer la caméra dans la scène côtière.
Mode: Standard image-to-video
Input: La paire de frames fournie est présentée ci-dessous : le portrait de studio comme frame de départ et la côte au coucher du soleil comme frame de fin.
File: environ 6 secondes · 848 × 480 · 24 fps · piste audio présente
Example video
Input images
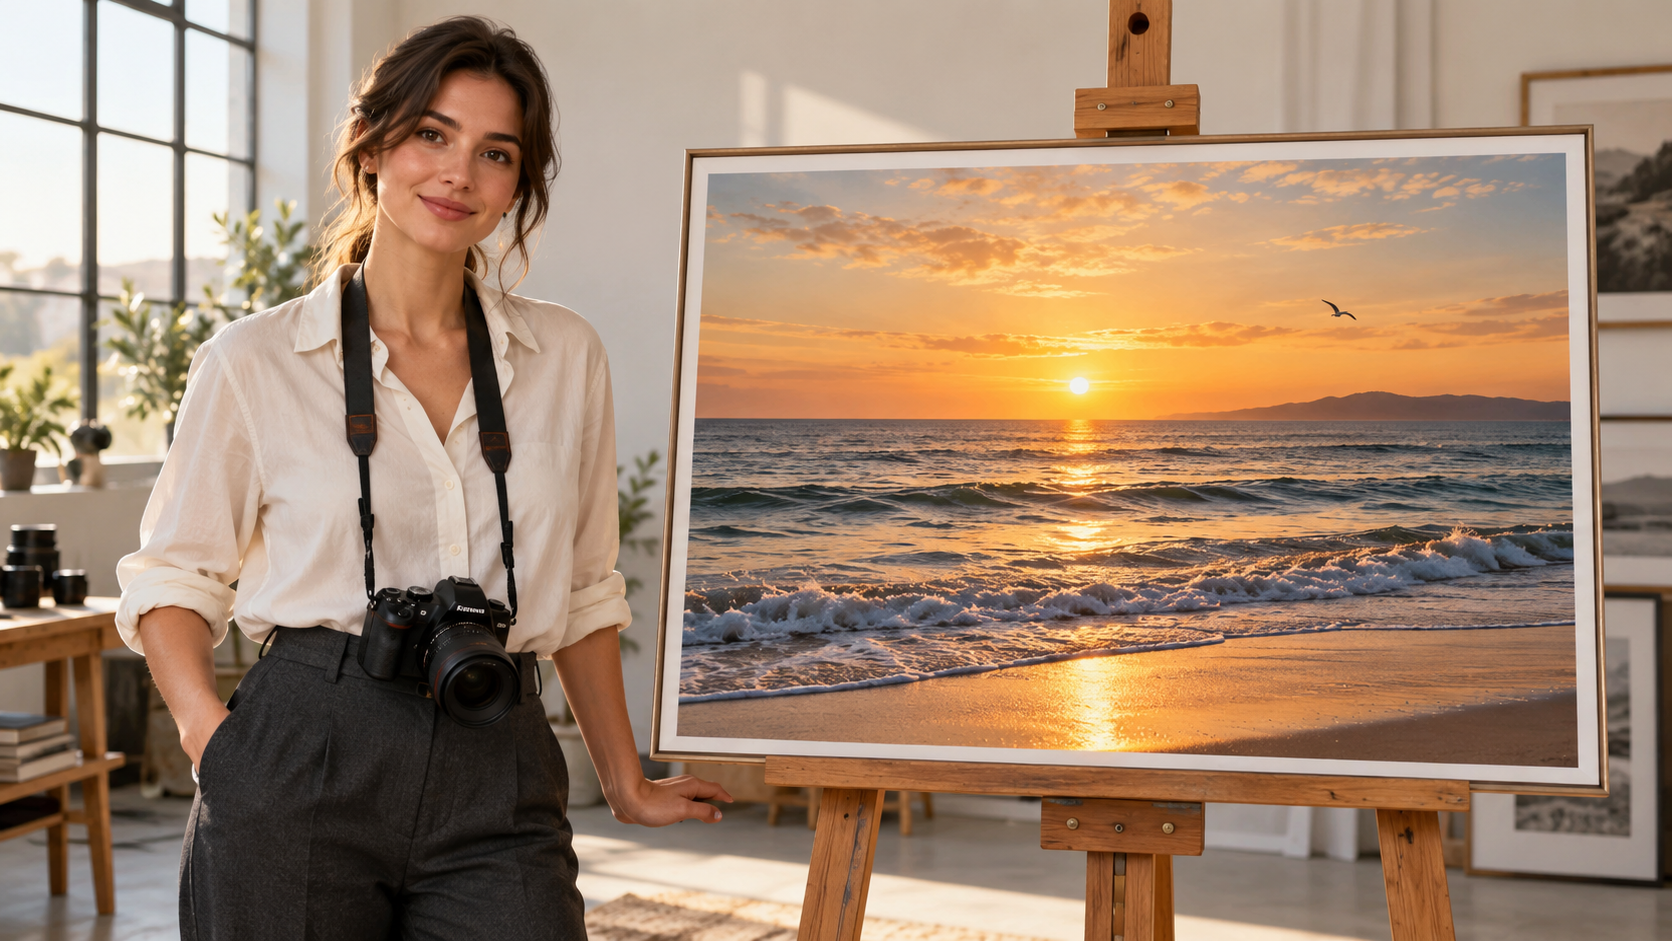
Starting frame: photographer and framed seascape
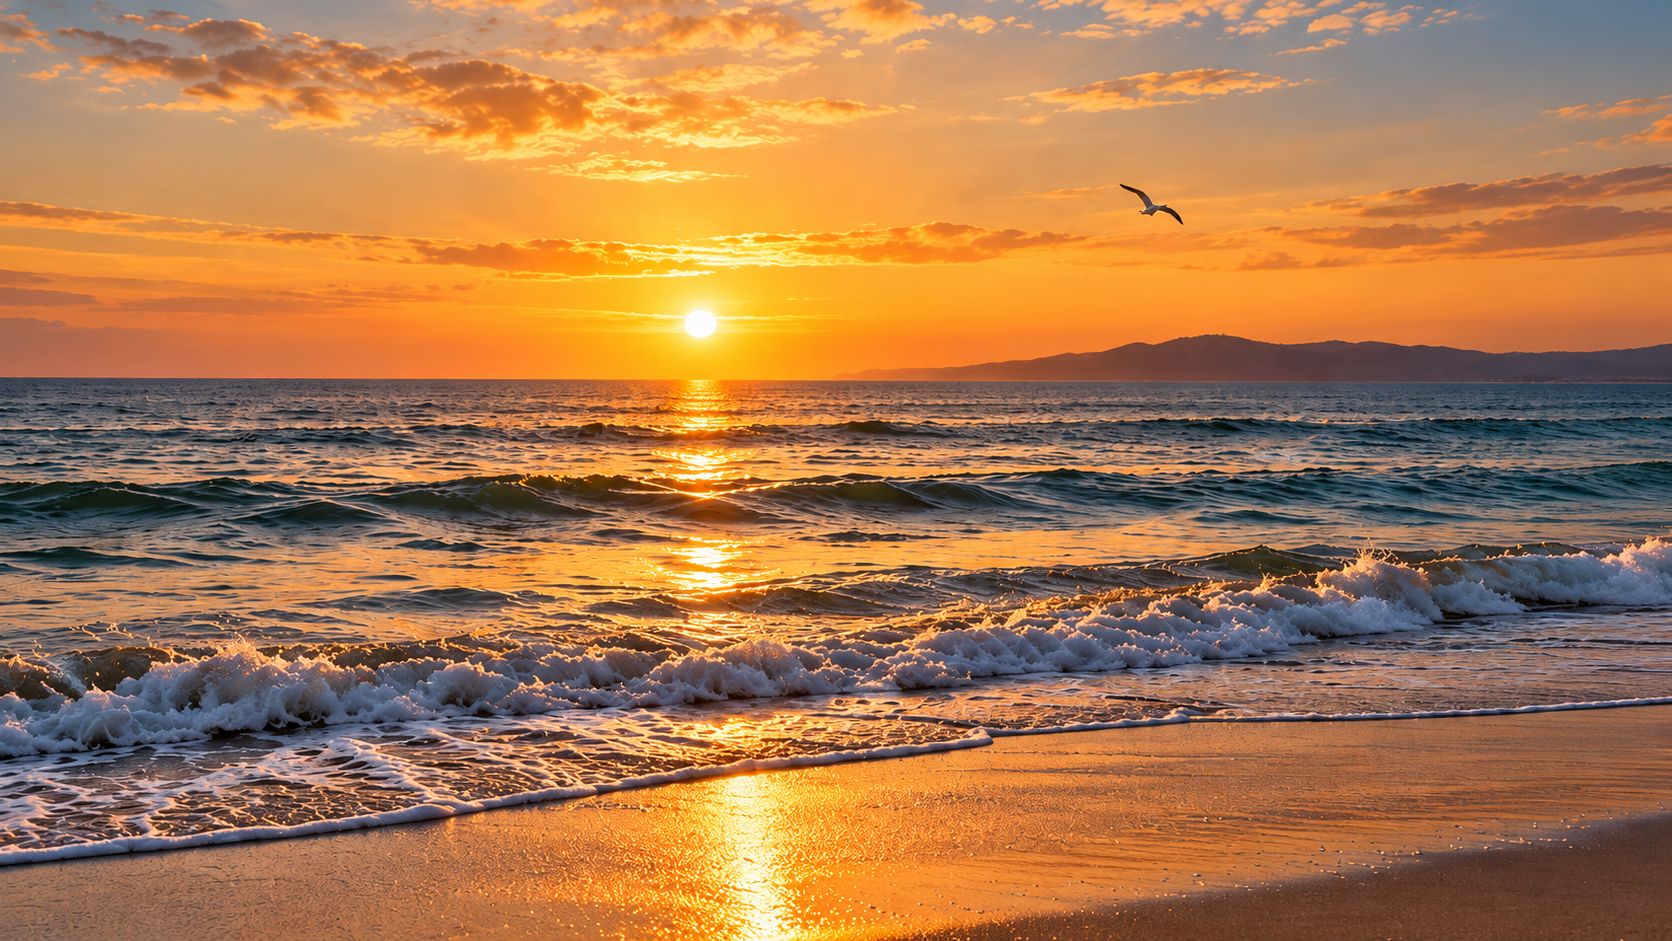
Ending frame: sunset coast
Original generation prompt
Photorealistic cinematic style, set in a modern photography studio. A young adult female photographer stands beside an easel displaying a photograph of a beach at sunset. She looks at the photograph, then turns toward the camera and smiles. She speaks in English:
“Let’s bring this photo to life! I made this on Kinovi using the grok-imagine-video-1.5 image-to-video model.”
As she gently gestures toward the photograph, the camera slowly pushes in. The waves within the photograph begin to roll naturally, sunlight shimmers across the water, and a seagull flies through the scene. The photograph’s frame gradually moves out of view until the moving seaside scene fills the entire screen. Natural gestures, accurate lip synchronization with the English dialogue, soft lighting, and a seamless transition. Clear voice audio accompanied by gentle ocean sounds. No added subtitles.
Ce que montre la sortie
Dans la sortie d’environ six secondes, la photographe sourit, bouge la bouche et fait un geste vers l’image. La caméra s’approche du cadre pendant que les vagues changent ; à la fin, le studio et le cadre ont quitté le champ et le bord de mer remplit l’écran. La transition entre les deux compositions fournies est visible dans le résultat.
Ce clip illustre la continuité visuelle frame à frame. Le prompt demande aussi une réplique en anglais, mais le seul mouvement de la bouche ne prouve pas que la phrase entière a été dite ou synchronisée mot à mot. Avec une durée aussi courte, l’achèvement du dialogue doit être vérifié séparément.
Où cette approche convient
Une approche utile pour l’animation de photos, les visuels de voyage et les transitions vers un monde photographié. Définissez le lien prévu entre les deux frames, et laissez assez de temps pour le mouvement de caméra et la parole.
3. Standard reference-to-video : combiner une montre, un piédestal et une pièce
Le reference-to-video peut réunir dans une seule scène des assets séparés de produit, de présentoir et de lieu. Ce concept de montre attribue un rôle à chaque image, puis demande un gros plan du cadran, une vue autour du boîtier et un plan final plus large.
Mode: Standard reference-to-video
Input: Téléversez dans cet ordre : IMAGE_0 montre, IMAGE_1 piédestal en marbre, IMAGE_2 intérieur. Les libellés du prompt renvoient à ce même ordre.
File: environ 8 secondes · 752 × 416 · 24 fps · piste audio présente
Example video
Input images
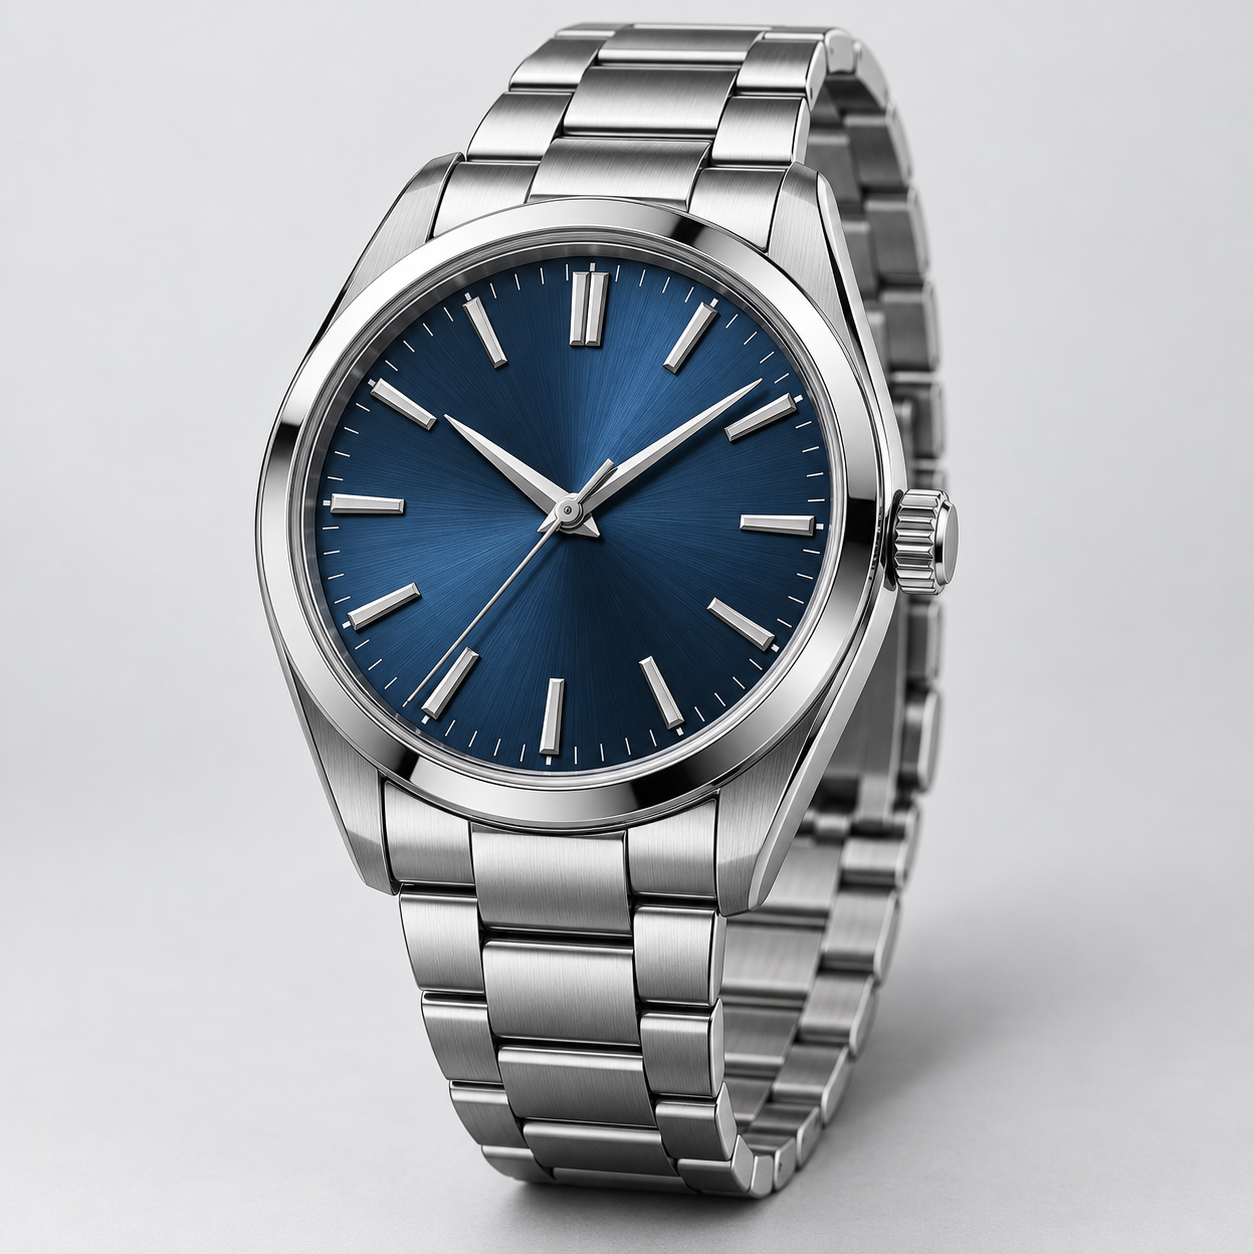
IMAGE_0: silver case and blue dial
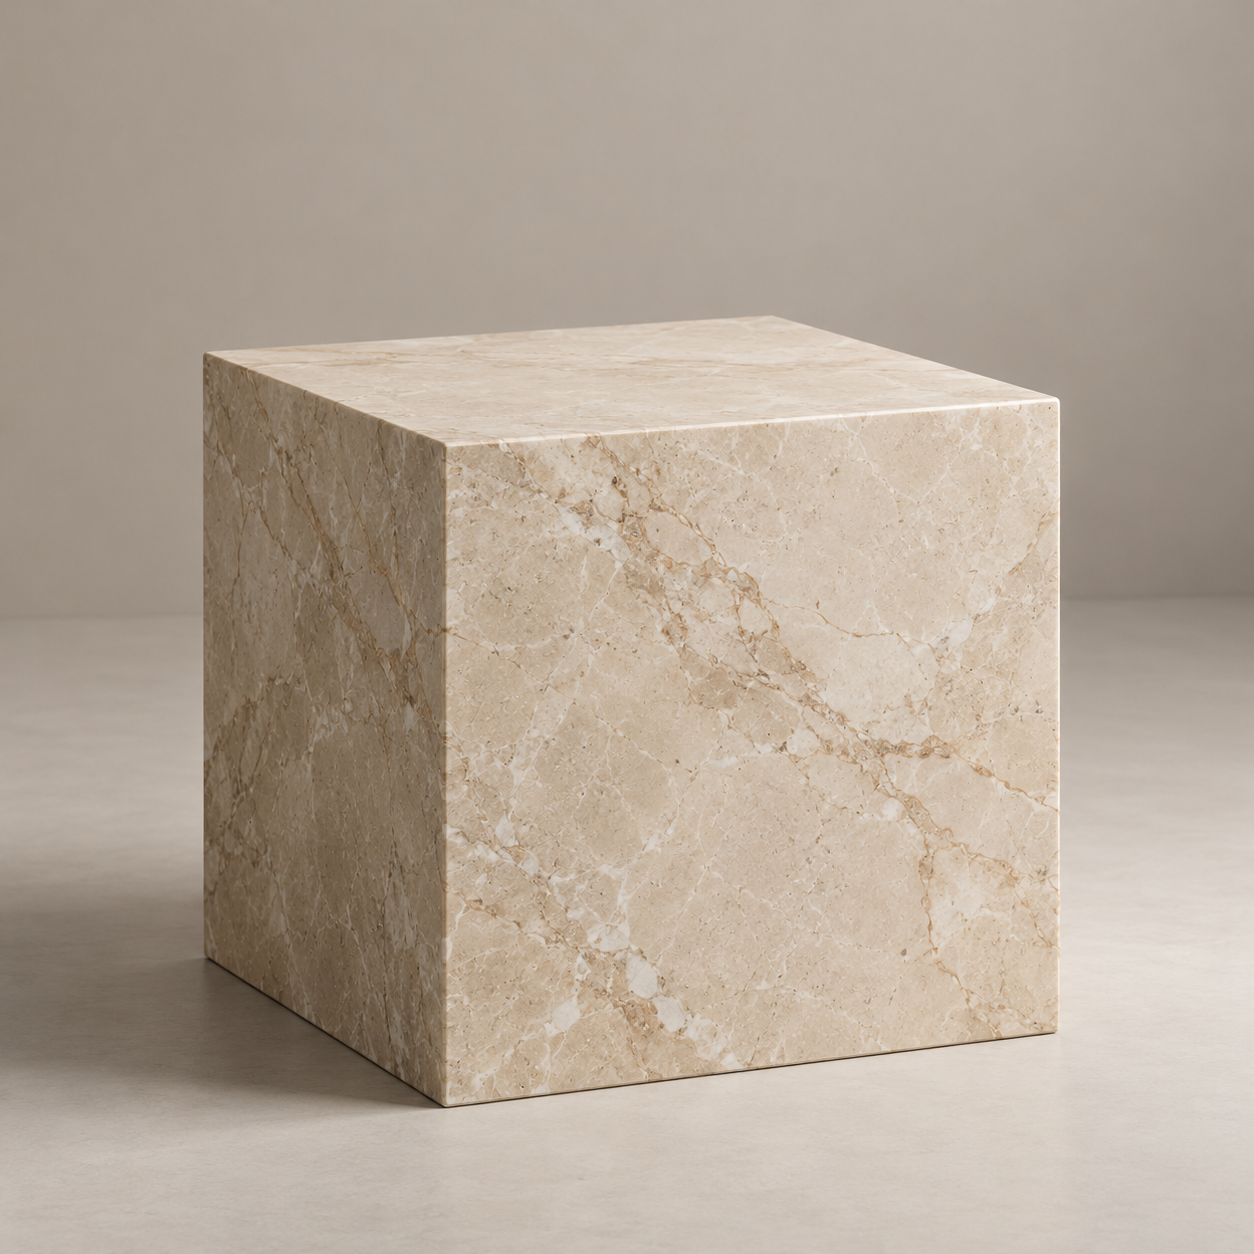
IMAGE_1: beige marble pedestal
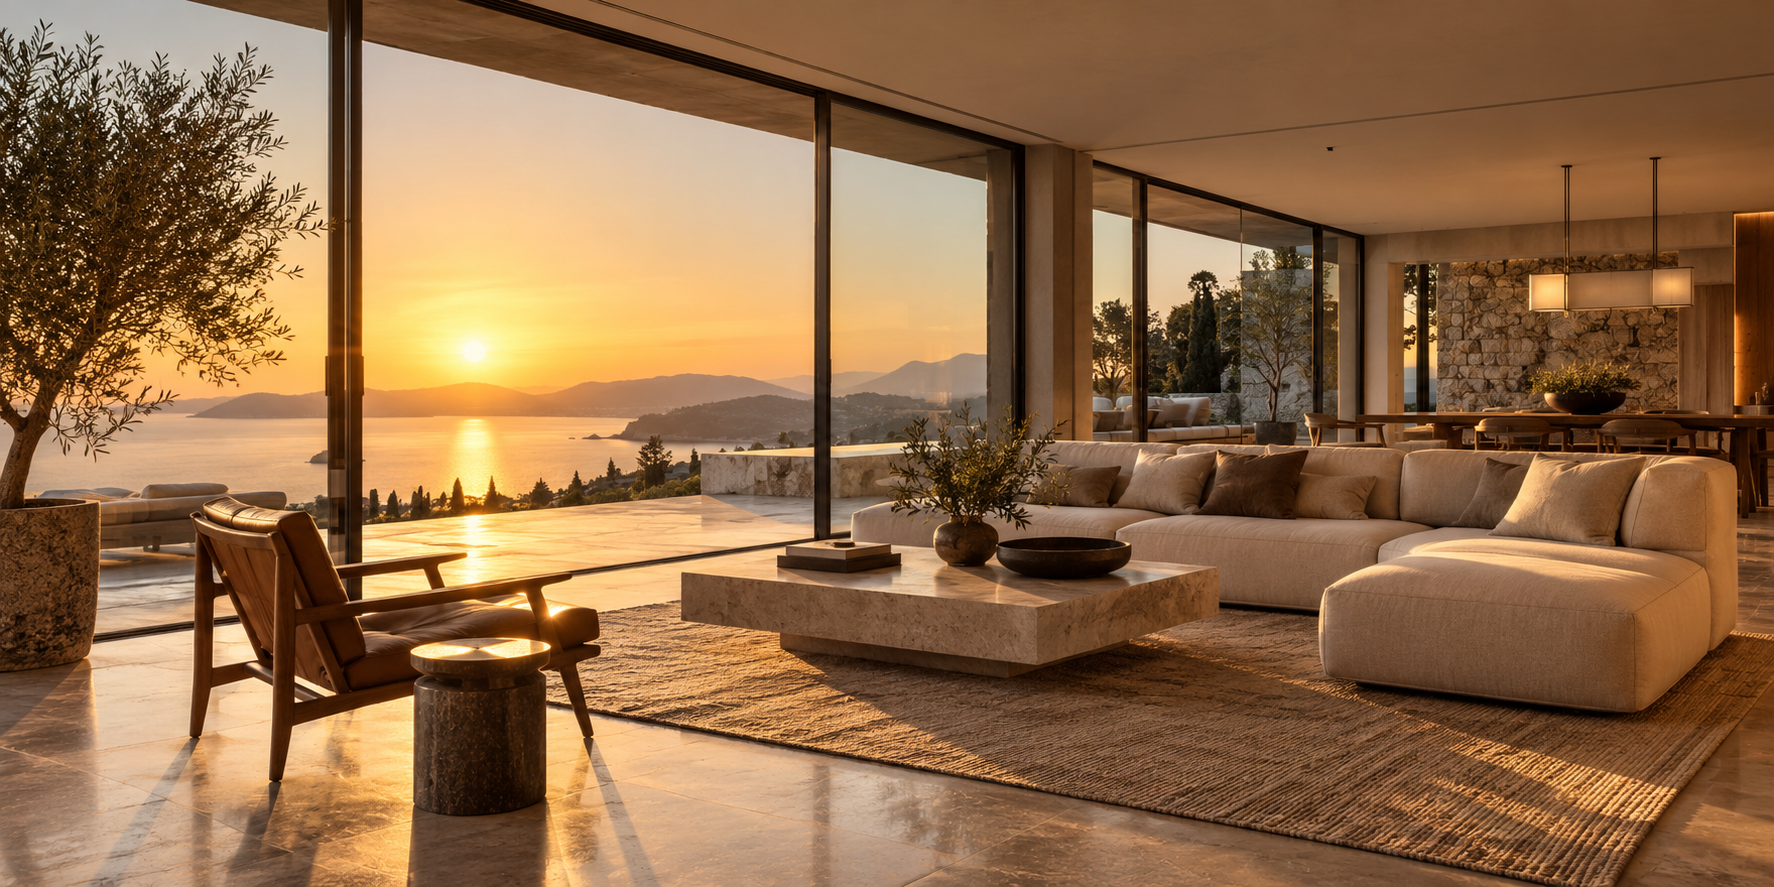
IMAGE_2: golden-hour interior
Original generation prompt
Create an 8-second luxury watch commercial by combining three reference images.

<IMAGE_0> is the exact watch product reference. Preserve its silver metal case, blue dial, hands, hour markers, crown placement and bracelet design.
<IMAGE_1> defines the beige marble pedestal and its surface texture.
<IMAGE_2> defines the warm golden-hour interior environment and lighting.

Place the exact watch from <IMAGE_0> upright on the marble pedestal from <IMAGE_1>, inside the setting from <IMAGE_2>.

0–2s: Extreme close-up of the watch dial. Fine metallic reflections reveal the watch's craftsmanship.

2–5s: The camera performs a slow cinematic orbit around the watch, revealing the case thickness, crown and metallic bracelet without altering their original geometry.

5–8s: The camera pulls back to reveal the watch resting on the marble pedestal, with warm sunlight and realistic shadows across the surface.

Maintain exact watch identity and material details throughout. Physically accurate metal reflections, consistent dial markings, realistic contact shadows and correct perspective.

Audio: Subtle mechanical ticking, luxurious ambient music and a gentle final musical accent.

No added logos, no invented text, no product redesign. 16:9.
Ce que montre la sortie
La sortie s’ouvre près du cadran bleu, révèle la couronne, le boîtier et le bracelet, puis recule pour montrer la montre dressée sur une surface de marbre. Les trois ingrédients majeurs — le produit, le présentoir et l’intérieur chaud — sont représentés.
Le produit n’est cependant pas une réplique exacte. La montre fournie n’a pas de guichet de date, alors que le gros plan généré introduit une fonction guichet/loupe. L’exemple démontre la composition multi-images et le design de plan publicitaire ; il n’établit pas une fidélité produit parfaite. Les détails du cadran, les index, le placement de la couronne et la structure du bracelet nécessitent une vérification séparée avant usage dans une publicité produit.
Où cette approche convient
Utile pour les propositions de mise en scène produit et les concepts publicitaires. Attribuez des rôles explicites à chaque référence et inspectez les détails produit générés avant de traiter le clip comme une démonstration produit fidèle.
4. Lite text-to-video : laver une lune à 2 h du matin
Un astronaute, une laverie et une lune partagent un même décor. Le personnage reste presque immobile, tandis que la caméra, le tambour et l’eau fournissent le mouvement autour d’un point focal surréaliste.
Mode: Lite text-to-video
Input: Texte uniquement ; aucune image de référence.
File: environ 8 secondes · 848 × 480 · 24 fps · piste audio présente
Example video
Original generation prompt
An 8-second cinematic shot inside a quiet, slightly worn neighborhood laundromat at 2 a.m. Rain streaks the storefront windows. A single astronaut sits motionless on a plastic chair, holding an empty laundry basket.

Inside the oversized circular window of the central washing machine, a luminous three-dimensional moon slowly rotates like a heavy object in a wash cycle. Its craters remain clearly visible. A thin ring of water slides around the bottom of the drum, catching silver moonlight.

The camera makes one slow, deliberate push toward the machine. Its warm interior glow gently illuminates the astronaut's visor and the scratched tile floor, contrasting with the cool fluorescent ceiling lights.

Treat this impossible scene with understated photographic realism: restrained colors, tactile surfaces, subtle film grain, controlled highlights. The moon stays inside the drum throughout. One continuous shot, no cuts.

Audio: a low mechanical hum, water softly sloshing, distant rain. No dialogue or music.
Ce que montre la sortie
La caméra se rapproche pendant que l’astronaute est assis tenant un panier. La lune lumineuse reste dans le tambour surdimensionné, et sa lumière chaude se reflète sur le sol mouillé. La composition véhicule clairement l’idée d’attendre qu’une lune finisse son lavage.
La sortie ajoute aussi de l’eau qui déborde du tambour et s’accumule sur le sol, au-delà du mince anneau d’eau à l’intérieur de la machine demandé par le prompt. Les changements à la surface de la lune ne suffisent pas à eux seuls à vérifier une rotation tridimensionnelle physiquement cohérente. Cela établit l’idée visuelle tout en montrant comment le modèle peut enrichir les détails.
Où cette approche convient
Une direction à explorer pour l’idéation visuelle à budget maîtrisé, les plans atmosphériques et les clips sociaux. Cette scène diffère de l’exemple text-to-video standard, ce n’est donc pas une comparaison contrôlée de leur qualité.
5. Lite image-to-video : donner de la vie à un portrait de mode
La référence de départ sélectionnée correspond au costume ivoire et au décor de terrasse de la sortie. La personne, la tenue, la chaise, le mur et le rideau transparent sont déjà définis, donc la vidéo se concentre sur de petits mouvements du visage, des cheveux et du tissu.
Mode: Lite image-to-video
Input: Une image de départ : une femme assise en costume ivoire sur une terrasse.
File: environ 15 secondes · 736 × 400 · 24 fps · piste audio présente
Example video
Input images
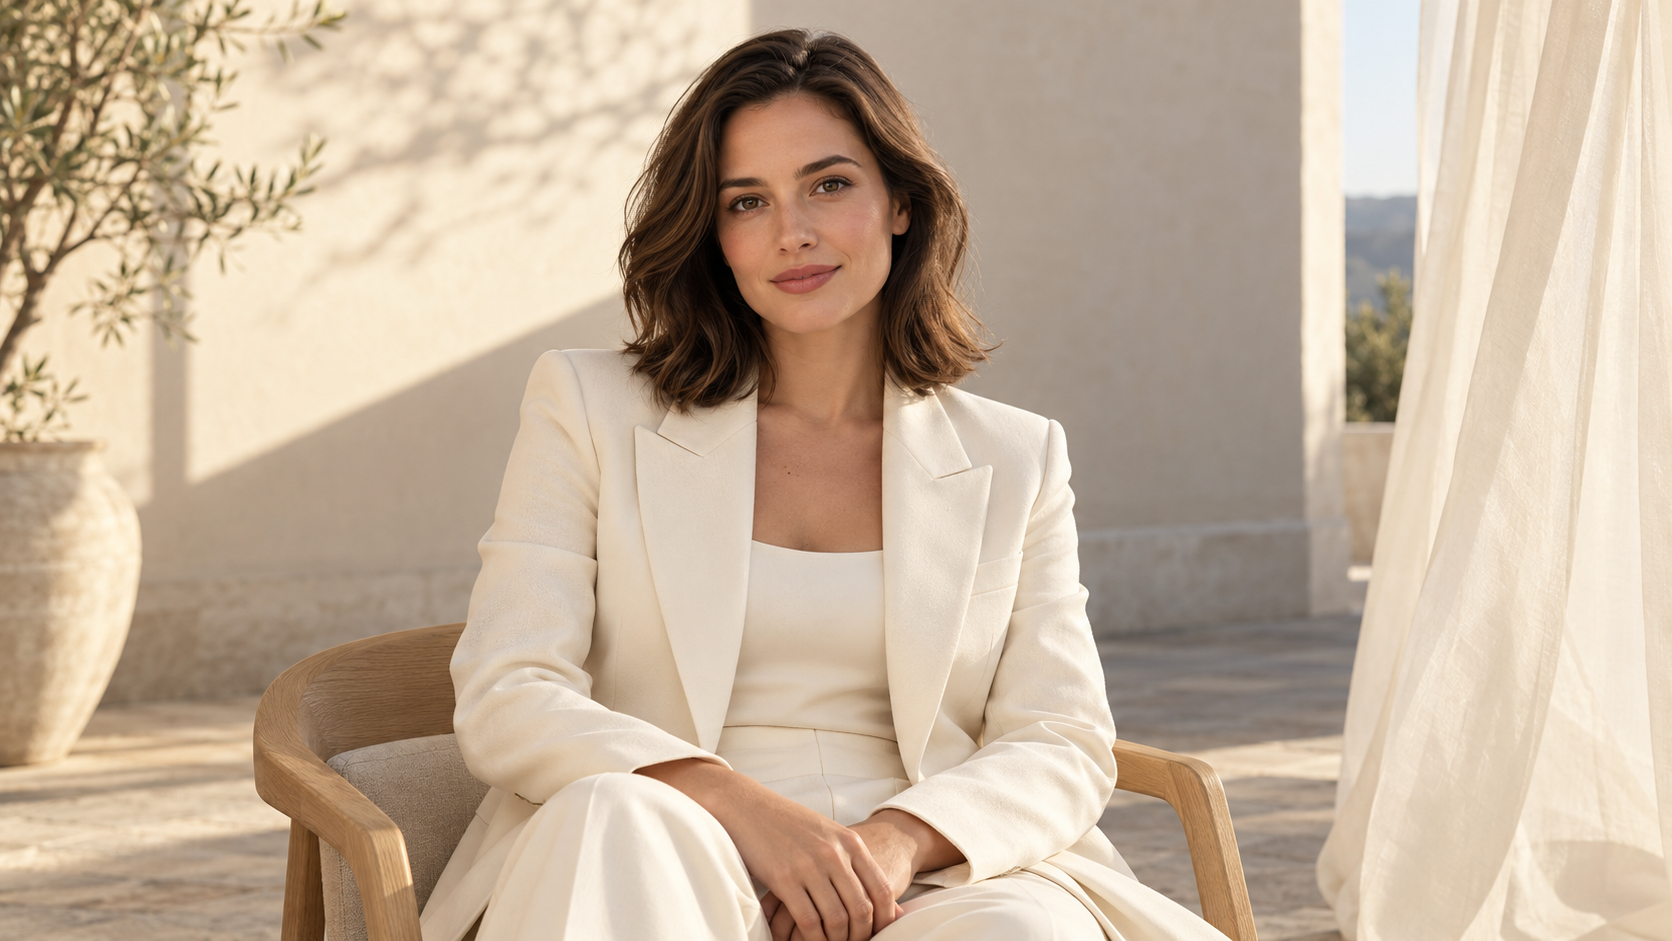
Starting frame: ivory-suit terrace portrait
Original generation prompt
Use the uploaded portrait as the first frame of a 15-second, 16:9 premium fashion talking-portrait film. Preserve the adult woman’s identity, hairstyle, ivory suit, seated pose, chair, architectural terrace, warm-white wall, sheer curtain, and original composition. Use a locked, eye-level medium shot. Do not change her outfit, location, or identity.

From 0 to 2 seconds, begin naturally from the input image. A gentle breeze moves a few strands of hair beside her ear and the translucent ivory curtain at the side of the frame. Keep the curtain near the image edge, never over her face. She blinks softly, with subtle, natural breathing through her shoulders.

From 2 to 12.5 seconds, she looks into the lens and speaks in composed, confident English: “A portrait can have a cinematic sense of life. I made this with Grok one point five Lite image-to-video on Kinovi.” Her delivery feels like a model sharing a creative moment after a shoot, not a loud sales pitch. Use clear diction and natural pauses. The visible woman speaks the entire line with accurate lip sync. Keep her hands relaxed and use only small eye and head movements; no waving.

From 12.5 to 15 seconds, after the dialogue, she briefly looks toward the sunlight at the side and returns to the camera with a faint smile. The hair and curtain continue moving gently. Hold the camera still and end on the complete fashion-portrait composition.

Champagne-colored side light, soft geometric shadows, realistic skin and suit fabric, and layered, restrained warm whites. No excessive beauty filtering, plastic skin, or strong lens flares. Clear speech, gentle wind, and a very quiet original sparse-piano bed beneath the voice. No off-screen narration, subtitles, magazine cover text, logos, or added on-screen lettering. Maintain stable facial features and clothing. No large head turns or curtain passing through the body.
Ce que montre la sortie
Le clip d’environ 15 secondes reste centré sur le sujet assis. Le costume ivoire, la chaise et le décor blanc chaud restent reconnaissables dans les images échantillonnées. Sa bouche et son expression changent, le rideau bouge, et la fin revient à une expression plus calme.
Le clip illustre une animation subtile d’un portrait existant. Des vêtements et un environnement reconnaissables n’établissent pas une préservation d’identité frame-parfaite. L’achèvement du dialogue, la prononciation et la synchronisation audiovisuelle nécessitent aussi leur propre vérification en lecture.
Où cette approche convient
Une configuration utile pour les présentations personnelles, l’animation de portraits de mode et le contenu talking-head mesuré. Une image de départ claire et un petit ensemble de mouvements rendent le résultat prévu plus facile à définir.
4. Commencer à créer sur Kinovi
- Choisissez le mode d’entrée. Utilisez text-to-video pour une idée, image-to-video pour une composition existante, ou reference-to-video pour plusieurs assets visuels.
- Préparez le matériel. Rendez l’image de départ claire et l’image de fin intentionnelle. Pour les références, gardez l’ordre de téléversement cohérent et attribuez un rôle à chaque image dans le prompt.
- Réglez la durée et la qualité de sortie. Laissez du temps pour la parole et le mouvement de caméra. Vérifiez la résolution, l’audio, les paramètres de cadrage pris en charge et le prix actuel.
- Relisez ce qui compte pour le projet. Vérifiez les visages, les mains et le mouvement des lèvres pour les personnes ; la géométrie, le lettrage et les matériaux pour les produits ; et le début, la fin et le mouvement intermédiaire pour les transitions.
Ouvrir une option de génération
- Standard text-to-video
- Standard image-to-video
- Standard reference-to-video
- Lite text-to-video
- Lite image-to-video
5. À retenir : choisissez d’abord le flux de travail, puis évaluez la version
Les cinq vidéos partent de types de matériel différents. La boutique de fleurs construit une scène à partir du texte ; le clip de studio relie deux compositions ; la pub de montre combine des références ; la laverie lunaire explore un concept surréaliste au tarif listé plus bas de Lite ; et le portrait de mode prolonge un personnage et un décor existants.
Commencez par la tâche. Pour plusieurs références ou une image de fin, consultez l’option standard correspondante. Pour des idées textuelles ou l’animation d’une seule image, incluez Lite dans vos essais. Comparez ensuite les sorties de la même tâche pour décider si le détail, la qualité visuelle et le coût répondent à vos besoins.
Une ambiance convaincante ne signifie pas que chaque instruction a été suivie, et une pub attrayante ne garantit pas un produit exact. Un flux de travail utile laisse de la place à la génération créative et à une relecture attentive avant publication.
6. Foire aux questions
1. Ces cinq options sont-elles des modèles complètement séparés ?
Une façon plus utile de s’y retrouver est deux versions — standard et Lite — avec différents modes d’entrée. Kinovi les liste comme options séparées pour que les créateurs puissent choisir selon la tâche.
2. En quoi image-to-video et reference-to-video diffèrent-ils ?
Image-to-video part d’une composition précise ; l’option standard peut aussi prendre une image de fin. Reference-to-video utilise des images pour définir des sujets, produits ou environnements sans traiter automatiquement la première référence comme frame d’ouverture fixe. L’un prolonge une composition ; l’autre combine des sources visuelles.
3. Les vidéos peuvent-elles inclure de la parole et de l’audio d’ambiance ?
Les cinq options exposent la génération audio. Les prompts peuvent demander dialogue, ambiance, effets et musique, mais l’achèvement de la parole, la prononciation et la synchronisation doivent être vérifiés dans la sortie. Les répliques plus longues ont besoin de suffisamment de durée.
4. Tous les modes prennent-ils en charge le 1080p et les frames de début/fin ?
Non. Les text-to-video et image-to-video standard et Lite listent le 1080p, tandis que le reference-to-video plafonne à 720p. L’image-to-video standard est limité à 720p lorsqu’une image de fin est utilisée. L’image-to-video Lite accepte une seule image de départ, et sa sortie 1080p est upscalée.
5. Lite est-il plus rapide ou égal au standard en qualité ?
Ces exemples n’incluent ni enregistrements de temps de génération comparables ni tâches appariées, donc ils n’établissent ni parité de vitesse ni de qualité. Cet article n’équivaut pas non plus Lite à la version Fast de l’annonce xAI.
6. Comment estimer le coût ?
Multipliez le tarif actuel par seconde de l’option et de la résolution choisies par la durée de sortie. Vérifiez les conditions applicables de nouvelle tentative, d’échec et promotionnelles. Un fichier vidéo d’exemple seul n’établit pas le montant facturé pour sa génération.
7. Les références peuvent-elles garantir un produit inchangé ?
Cet exemple ne soutient pas cette garantie. La sortie de la montre ajoute une fonction guichet/loupe absente de la référence. Pour le marketing produit, inspectez le cadran, le lettrage, la géométrie et les détails structurels avant d’approuver le résultat.
8. Les instructions de timing du prompt seront-elles suivies à la seconde près ?
Les plages horaires communiquent le rythme, mais ce n’est pas une timeline de montage précise. Les paramètres de génération réels déterminent la durée disponible, et le modèle peut révéler un décor tôt ou enrichir un effet. Priorisez la parole et les actions essentielles.
Sources et notes de vérification
Les spécifications et tarifs des plateformes ont été vérifiés le 21 octobre 2026. Les attributions de modèles, prompts et images d’entrée suivent le matériel de cas fourni ; les durées et dimensions de sortie ont été lues dans les fichiers. Les vidéos d’origine n’ont pas été montées, doublées ni sous-titrées pour cet article. Les exemples illustrent des flux de travail plutôt qu’un classement global des modèles.
Articles associés
More to try
Modèles associés
ByteDance · video model
Seedance 2.0
Modèle vidéo IA de nouvelle génération par ByteDance. Combine les modes Fast et Pro pour générer des vidéos de haute qualité.
$0.0707/s
Midjourney · image model
Midjourney V8
Le dernier modèle Midjourney avec une qualité photoréaliste et un contrôle créatif.
$0.0565/4 images
OpenAI · image model
GPT Image 2
Modèle avancé de génération et d'édition d'images IA par OpenAI. Comprend les concepts complexes et génère des images détaillées et réalistes à partir de texte.
$0.0100/image